
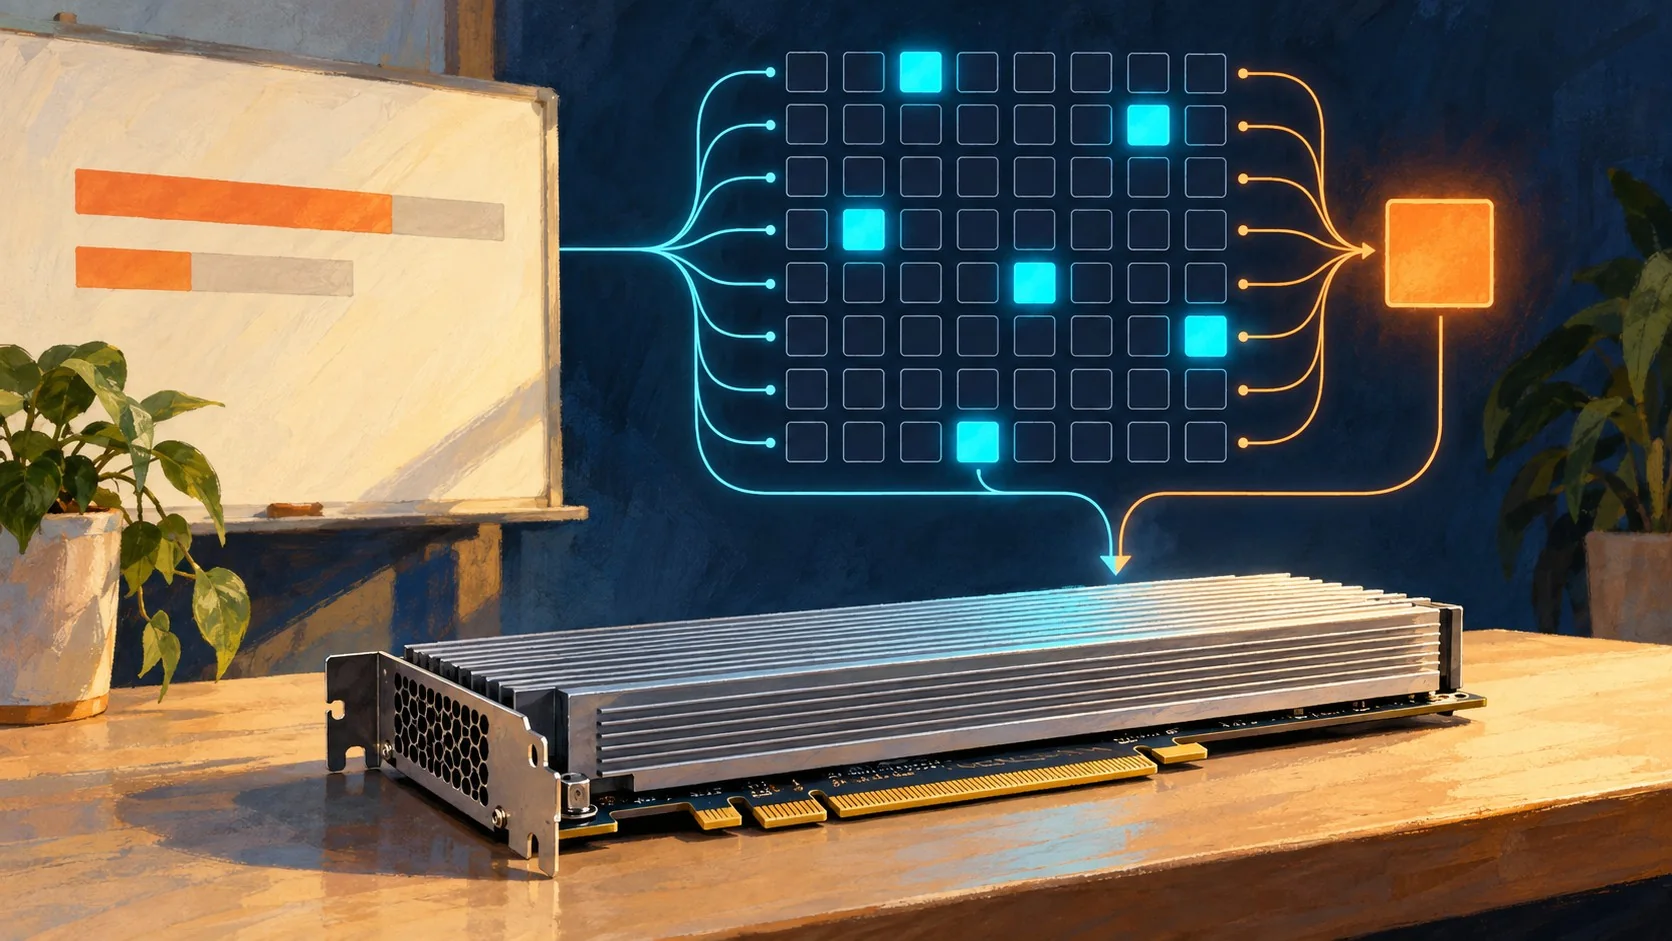
En pocas palabras: El 7 de octubre de 2026, Shivam Kumar, de VisionQuantech, diseñó DeepSeekMoE-tiny: un modelo Mixture-of-Experts de 188.269.568 parámetros totales y 51.430.400 activos por token, con 64 micro-expertos más uno compartido por capa y routing top-6, para entrenarlo en una GPU T4 gratuita de Colab, a costo cero.
Shivam Kumar, fundador de VisionQuantech, publicó el 7 de octubre de 2026 el diseño de un modelo MoE desde cero: 188.269.568 parámetros totales y 51.430.400 activos por token, pensado para entrenarse en una GPU T4 gratuita de Colab. El entrenamiento seguía en curso.
Un modelo Mixture-of-Experts (MoE) es una arquitectura de red neuronal que reemplaza capas MLP del transformer por varias subredes expertas y un router que elige cuáles procesan cada token. En un MoE disperso trabaja solo un subconjunto de expertos por token, así que el modelo guarda más conocimiento del que gasta en cómputo. DeepSeekMoE es la variante de DeepSeek que este proyecto independiente toma prestada; el proyecto no es de DeepSeek.
En este artículo:
- En 30 segundos
- ¿Qué significa que un MoE tenga 188M de parámetros y use solo 51M por token?
- ¿Cómo funciona un MoE por dentro: router, expertos y experto compartido?
- ¿Cómo está armada la arquitectura de este modelo MoE desde cero?
- ¿Qué midieron los experimentos y qué no prueban?
- ¿Un MoE chico rinde mejor que un denso con el mismo cómputo?
- ¿Se puede entrenar un modelo MoE desde cero en una GPU T4 gratis de Colab?
- ¿Qué está confirmado y qué falta confirmar del proyecto?
- Errores comunes al leer (o copiar) un proyecto como este
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El modelo tiene 188.269.568 parámetros totales y 51.430.400 activos por token: el cómputo de un denso de unos 51M con unas 3,7 veces su capacidad.
- La arquitectura, DeepSeekMoE-tiny, tiene 8 capas, 64 micro-expertos más 1 compartido por capa y routing top-6.
- Cuatro candidatos corrieron 300 pasos en CPU (loss de 41,5 a 7,6, sin NaN ni colapso). Los experimentos prueban balance y estabilidad, no calidad.
- El entrenamiento en una T4 de Colab (unos 215M tokens, 2,5 a 3 horas, US$0) estaba en marcha y no hay resultados finales.
¿Qué significa que un MoE tenga 188M de parámetros y use solo 51M por token?
Significa que el modelo guarda 188.269.568 parámetros, pero el router activa solo 51.430.400 para cada token. Un denso de 188M dispara todos en cada palabra. Según el post de Kumar, el MoE gasta el cómputo de un denso de unos 51M y tiene unas 3,7 veces su capacidad.
Ojo con la letra chica: el ahorro es de cómputo, no de memoria. Según el blog técnico de NVIDIA, un MoE disperso usa menos cómputo que un denso del mismo tamaño pero necesita la misma memoria, porque con lotes grandes casi todos los expertos terminan trabajando. El ejemplo clásico es Mixtral 8x7B, que según NVIDIA usa unos 12,9 mil millones de parámetros por token sobre unos 47 mil millones totales. En este proyecto, la cuenta es simple (188,27 millones por 2 bytes en fp16, unos 377 MB de pesos, cálculo nuestro y sin contar optimizador ni activaciones).
Cómputo barato, memoria completa.
Una aclaración sobre el origen: Kumar es un desarrollador independiente y el post no menciona ninguna participación de DeepSeek. Lo único que comparten es la receta de arquitectura.
¿Cómo funciona un MoE por dentro: router, expertos y experto compartido?
El router puntúa los expertos para cada token y lo manda a los K mejores; las salidas se combinan por promedio o suma. En DeepSeekMoE hay además expertos compartidos que ven todos los tokens y guardan el conocimiento común. Así, los expertos ruteados no repiten lo mismo. Sobre eso hablamos en nuestra guía sobre modelos de lenguaje.
El paper de DeepSeekMoE propone dos estrategias: segmentar los expertos en mN y activar mK, para tener más combinaciones posibles, y aislar Ks expertos como compartidos para reducir la redundancia. Imaginate un signo de puntuación entrando al modelo: en el experimento de NVIDIA con Mixtral, la puntuación y las palabras interrogativas iban a expertos particulares en capas tempranas y tardías. NVIDIA también midió que, aun con balanceo de carga, el experto más ocupado recibía hasta un 40 a 60% más tokens que el menos ocupado.
¿Cómo está armada la arquitectura de este modelo MoE desde cero?
DeepSeekMoE-tiny tiene 8 capas, d_model de 512, 8 cabezas y contexto de 1024 tokens. Cada capa lleva 64 micro-expertos SwiGLU enrutados más 1 experto compartido siempre activo, con routing top-6. Los datos salen del post original.
| Parámetro | Valor |
|---|---|
| Parámetros totales | 188.269.568 |
| Parámetros activos por token | 51.430.400 |
| Capas / d_model / cabezas | 8 / 512 / 8 |
| Contexto | 1024 tokens |
| Expertos por capa | 64 micro-expertos SwiGLU (dim 192) + 1 compartido |
| Routing | token-choice top-6, pesos renormalizados |
| Pérdidas auxiliares | aux loss por experto (α=0,01) + router z-loss (1e-3) |
| Entrenamiento | dropless, fp16 |
Kumar probó primero un diseño con 9 expertos, uno por dominio, y lo descartó. Su razonamiento: el modelo tiene que rendir en todas las categorías, no en nueve cajones, y la especialización debe emerger del router, nunca asignarse a mano. Con 64 micro-expertos y top-6 hay unos 75 millones de combinaciones por capa al mismo costo de cómputo (cifra del post, y coincide con la combinatoria de elegir 6 entre 64), lo que alcanza para cubrir sintaxis, hechos y estilos de razonamiento sin etiquetas.
¿Qué midieron los experimentos y qué no prueban?
Cuatro de los cinco candidatos corrieron 300 pasos reales en CPU y los cuatro entrenaron estable, con loss de 41,5 a 7,6, sin NaN ni colapso. El ganador, DeepSeekMoE-tiny, logró aux loss de 2,03 y cero expertos muertos. Eso prueba balance y estabilidad. Calidad de lenguaje, no.
Los cinco candidatos eran tres con base en la literatura (estilo DeepSeekMoE, Switch y Mixtral), uno bioinspirado y un “moonshot”. Los puntajes de valor (función dividida por parámetros activos, con evidencia publicada) quedaron así: A 0,175, B 0,161, D 0,161, E 0,156 y C 0,097. El diseño estilo Mixtral fue el peor, porque gasta más cómputo activo para el routing más grueso.
| Diseño | Qué es | Resultado según el post |
|---|---|---|
| DeepSeekMoE-tiny | 64 micro-expertos + 1 compartido, top-6 | Ganador: aux loss 2,03, cero expertos muertos |
| Estilo Switch | Top-1, sin experto compartido, 37,3M activos por token | Eficiente en papel, pero top-1 a escala chica deja al router con poca señal de gradiente; perdió en valor |
| Bioinspirado | Balanceo por “fatiga” (promedio móvil del uso), sin aux loss | Casi balanceó, pero dejó 1 experto con utilización de 0,002; descartado como principal |
| Moonshot | Gate con pista de dominio y 50% de dropout de la pista | Pasó 5 chequeos lógicos (sin pista rindió algo mejor, brecha de -0,061); no superó al ganador y quedó archivado |
| Estilo Mixtral | Expertos gruesos | Último en puntaje de valor: 0,097 |
Acá viene lo importante: la información mutua entre clusters de datos y expertos dio cerca de 0 en todos los candidatos. El propio autor lo reconoce, 300 pasos de juguete no miden especialización y la evidencia de calidad sale de la literatura. Esa honestidad suma, y hay que leerla como parte del resultado. Te puede servir nuestra cobertura de la comparativa entre Google y DeepSeek.
Una observación nuestra, no de la fuente: un loss inicial de 41,5 es alto para un modelo de lenguaje. El post no aclara si la cifra incluye las pérdidas auxiliares o si usó otro vocabulario. Lo que no queda claro es qué mide exactamente ese número, así que tomalo con pinzas.
¿Un MoE chico rinde mejor que un denso con el mismo cómputo?
Para 188M todavía no hay dato. El paper de DeepSeekMoE reporta que su versión de 2B iguala a GShard 2,9B (que tiene 1,5 veces los parámetros de expertos y el cómputo) y que la de 16B iguala a LLaMA2 7B con cerca del 40% del cómputo. Son escalas muy distintas a la de este proyecto.
NVIDIA agrega el matiz contrario: frente a un denso del mismo tamaño total y los mismos tokens, el denso suele rendir mejor, aunque es un área de investigación abierta. La comparación justa para Kumar es contra un denso de unos 51M (mismo cómputo activo), y esa prueba la dejó pendiente.
¿Se puede entrenar un modelo MoE desde cero en una GPU T4 gratis de Colab?
Según el plan declarado, sí: Fase 1 con TinyStories (unos 200M tokens) y Fase 2 con datos de instrucciones (unos 15M tokens, incluidos los sets propios del autor y Dolly-15k). Son unos 215M tokens, entre 2,5 y 3 horas y US$0. Es un plan, no un resultado, porque el entrenamiento seguía corriendo cuando se publicó el post.
Ponele que Colab te desconecta a la hora y media de entrenamiento, algo que cualquiera que haya usado el plan gratuito vivió. El entrenador de Kumar incluye guardrails para eso, producto de un ejercicio de inversión (“¿cómo garantizo que esto falle?”) que dio 8 en total. Los que nombra el post: Complementá con armar un chatbot con varios modelos.
- Monitor de colapso del router: avisa fuerte si más del 25% de los expertos queda casi muerto.
- Auto-reducción del micro-batch: lo divide a la mitad ante un error de memoria (OOM).
- Aborto por NaN: corta y deja diagnóstico.
- Checkpoints cada 1.000 pasos: con
--resumepara retomar tras una desconexión de Colab.
Subís el notebook, lo dejás corriendo, Colab te corta, retomás desde el último checkpoint, perdés a lo sumo mil pasos y seguís, que es exactamente el tipo de rutina que hace viable un proyecto a costo cero. Eso sí: ningún guardrail garantiza que el modelo salga bueno.
¿Qué está confirmado y qué falta confirmar del proyecto?
Lo que el post reporta
- Arquitectura y conteo de parámetros: 188.269.568 totales y 51.430.400 activos, declarados por el autor.
- Estabilidad en CPU: cuatro candidatos, 300 pasos cada uno, sin NaN ni colapso.
- Balance del ganador: aux loss 2,03 y cero expertos muertos.
- Repo disponible: el post dice que incluye trazas de investigación, documentación, modelo y entrenador.
Lo que falta
- Resultados del entrenamiento completo: no hay números finales.
- Uso real de los expertos: si el modelo completo aprovecha los 64 micro-expertos.
- Comparación con un denso de ~51M: la prueba que dirá si el diseño vale la pena.
- Evaluación independiente: hoy todo viene del propio autor.
Kumar prometió publicar los números “digan lo que digan, incluso si son malos” (traducción nuestra del post). ¿Alguien lo verificó de forma independiente? Todavía no.
Propuesta editorial para cuando salgan los resultados: revisá tres cosas. Primero, el loss de validación del MoE contra un denso de ~51M entrenado con los mismos tokens y pasos. Segundo, la utilización por experto en cada capa, buscando casos como el 0,002 del candidato bioinspirado. Tercero, si la información mutua entre clusters y expertos dejó de ser ~0. Si falla alguna, el diseño sigue siendo didáctico pero no una mejora demostrada.
Hoy el proyecto sirve como receta reproducible y como ejemplo de cómo descartar diseños con criterio, no como modelo para producción. Si estás aprendiendo MoE, la tabla de candidatos descartados vale más que el ganador. En proteger un modelo autohospedado con nginx y firewall profundizamos sobre esto.
Errores comunes al leer (o copiar) un proyecto como este
- Confundir parámetros activos con memoria: los 188M tienen que estar cargados igual. Los 51M son solo el cómputo por token.
- Leer estabilidad como calidad: que el loss baje sin NaN en 300 pasos de CPU no dice nada sobre si el modelo escribe bien. El mismo autor lo aclara.
- Elegir el baseline equivocado: comparar contra un denso de 188M es otra pregunta que contra uno de ~51M. Definí cuál querés responder antes de mirar números.
- Atribuirle el proyecto a DeepSeek: es un desarrollo independiente que toma prestada una arquitectura publicada.
Preguntas Frecuentes
¿Qué es un modelo Mixture-of-Experts?
Es una arquitectura que divide una capa de la red en varias subredes “expertas” y combina sus salidas. En su versión dispersa, un router activa solo algunos expertos por cada token, lo que reduce el cómputo frente a un denso del mismo tamaño total, según NVIDIA.
¿Se puede entrenar un LLM desde cero en una GPU gratis de Colab?
A escala chica, el plan de Kumar dice que sí: un modelo de 188M parámetros con unos 215M tokens en 2,5 a 3 horas sobre una T4. Todavía no hay resultados finales, así que no se sabe qué calidad logra.
¿Qué diferencia hay entre parámetros totales y activos en un MoE?
Los totales son todos los pesos guardados en memoria (188.269.568 en este proyecto). Los activos son los que se usan para procesar un token (51.430.400). El cómputo depende de los activos, la memoria de los totales.
¿Qué es un experto compartido en DeepSeekMoE?
Es un experto que procesa todos los tokens, sin pasar por el router, para capturar conocimiento común y reducir la redundancia entre los expertos ruteados, según el paper. El modelo de Kumar usa uno por capa.
¿Un MoE chiquito rinde mejor que uno denso del mismo costo de cómputo?
A escala de 2B y más, el paper de DeepSeekMoE reporta resultados comparables con menos cómputo, pero para 188M no hay dato. Kumar prometió comparar contra un denso de ~51M y todavía no publicó esa prueba.
Conclusión
El proyecto de Kumar no demuestra que un MoE de 188M le gane a un denso, y él mismo no lo afirma. Lo que sí deja es un diseño documentado, cinco candidatos comparados con criterios explícitos y un entrenador con guardrails pensado para Colab gratis. Si querés aprender MoE con un caso chico, leé el repo y la tabla de descartes. Si buscás un modelo para usar, esperá a que salgan los números del entrenamiento completo y aplicá la verificación propuesta arriba.