En pocas palabras: Claude Opus 5.5, lanzado por Anthropic el 22 de septiembre de 2026, anotó 58 puntos en el Artificial Analysis Intelligence Index (mediana: 25), cuesta $4 por millón de tokens de entrada y $20 de salida, y ofrece una ventana de contexto de 1 millón de tokens.
En este artículo:
- En 30 segundos
- ¿Cuándo se lanzó Claude Opus 5.5 y qué significa la versión “Max”?
- ¿Qué puntaje obtuvo Claude Opus 5.5 en el Artificial Analysis Intelligence Index?
- ¿Cuánto cuesta usar Claude Opus 5.5 por token?
- ¿Por qué Claude Opus 5.5 genera más tokens que otros modelos de su categoría?
- ¿Cómo rinde Claude Opus 5.5 en programación y tareas agénticas?
- ¿Qué contexto, modalidades y límites tiene Claude Opus 5.5?
- ¿Cuánto bajó el precio de Claude Opus 5.5 frente a Opus 5?
- Qué significa para equipos técnicos en Latinoamérica
- Qué está confirmado y qué no sobre Claude Opus 5.5
- Errores comunes al evaluar Claude Opus 5.5
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Claude Opus 5.5 salió el 22 de septiembre de 2026, según confirmó Artificial Analysis.
- Score de 58 en el Intelligence Index v4.3.2, contra una mediana de 25 entre modelos de precio similar.
- Precio API: $4 por millón de tokens de entrada, $20 de salida, con 95% de descuento en cache hits.
- Genera 260 millones de tokens para completar el Intelligence Index, casi el triple de la mediana (88M).
- Terminal-Bench 4.0 pasó de 52,3% en Opus 5 a 66,4% en Opus 5.5, según Anthropic.
Claude Opus 5.5 es el modelo de razonamiento más reciente de Anthropic, lanzado el 22 de septiembre de 2026 dentro de la familia 5.5. Procesa texto e imágenes, devuelve solo texto, tiene una ventana de contexto de 1 millón de tokens y quedó evaluado por Artificial Analysis con 58 puntos en su Intelligence Index, bien arriba de la mediana de modelos comparables.
¿Cuándo se lanzó Claude Opus 5.5 y qué significa la versión “Max”?
Anthropic lanzó Claude Opus 5.5 el 22 de septiembre de 2026, según los datos de Artificial Analysis. La etiqueta “Max Effort, Adaptive Reasoning, Default Fallback” que aparece pegada al nombre no es un plan de suscripción aparte: es la configuración de razonamiento con la que Artificial Analysis corrió los benchmarks, la que le pide al modelo el mayor esfuerzo de pensamiento antes de responder.
Ojo con esto: si buscás “Claude Opus 5.5 Max” pensando en un producto distinto al Opus 5.5 estándar, te vas a confundir. Es el mismo modelo, con un dial de esfuerzo llevado al máximo.
El lanzamiento llegó dos meses después de Opus 5, presentado el 24 de julio de 2026, según reportó Infobae. Anthropic adelantó que Sonnet 5.5 y Haiku 5.5 llegan “en las próximas semanas” para completar la actualización de toda la familia 5.5, aunque todavía no confirmó una fecha exacta de lanzamiento.
¿Qué puntaje obtuvo Claude Opus 5.5 en el Artificial Analysis Intelligence Index?
Claude Opus 5.5 anotó 58 puntos en el Artificial Analysis Intelligence Index v4.3.2, bien por encima de la mediana de 25 entre modelos de un rango de precio comparable, según los datos publicados por Artificial Analysis. Ese índice combina 10 evaluaciones independientes, no una sola prueba.
Las evaluaciones que componen el índice son AA-Briefcase v1.1, GDPval-AA v2.1, AutomationBench-AA, Terminal-Bench 4.0, SciCode, Humanity’s Last Exam, GDP.pdf, CritPt, AA-Omniscience y AA-LCR v1.1. Cada una mide algo distinto: trabajo de conocimiento agéntico, tareas reales de 44 ocupaciones, uso de terminal, código, razonamiento y conocimiento factual con penalización por alucinación. Sobre eso hablamos en cómo se comparan Sonnet y Opus.
¿Alcanza ese puntaje para llamarlo el mejor modelo del mercado? Depende de con qué lo compares, y ahí Artificial Analysis mide solo contra modelos de precio similar, no contra todo el catálogo disponible.
¿Cuánto cuesta usar Claude Opus 5.5 por token?
Claude Opus 5.5 cuesta $4 por millón de tokens de entrada y $20 por millón de salida en la API de Anthropic, según confirma Artificial Analysis. Los cache hits tienen un descuento del 95%, lo que deja ese costo en niveles muy bajos para prompts repetidos.
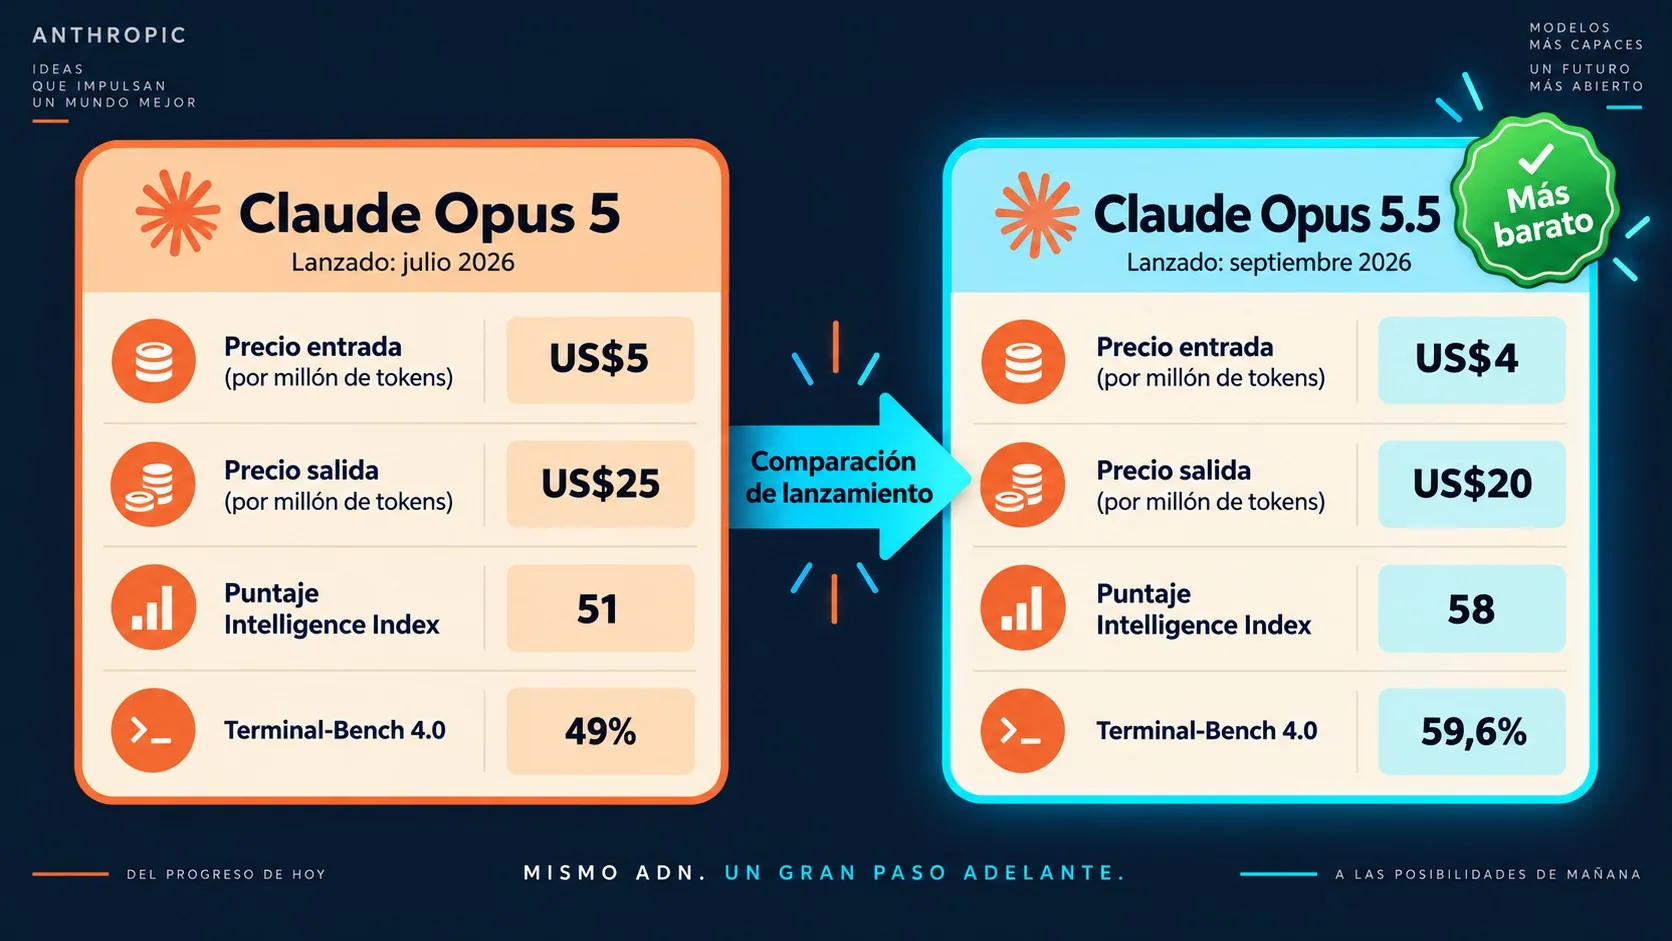
Eso representa una baja frente a Opus 5, que cobraba $5 de entrada y $25 de salida por millón de tokens. Es un dato histórico de referencia, no el centro de este análisis: el foco acá es cómo queda Opus 5.5 parado hoy, no cuánto bajó respecto al modelo anterior (aunque más abajo hay una tabla con el detalle completo).
El precio nominal por token está en la categoría “moderadamente caro” (en inglés, “somewhat expensive”) según la propia clasificación de Artificial Analysis, comparado con la mediana de $2 de entrada y $10 de salida entre modelos similares. Nominal, insisto, porque el costo real por tarea cuenta otra historia.
¿Por qué Claude Opus 5.5 genera más tokens que otros modelos de su categoría?
Claude Opus 5.5 generó 260 millones de tokens de salida para completar el Intelligence Index, frente a una mediana de 88 millones entre modelos comparables, según Artificial Analysis. Es casi el triple de verbosidad que sus pares de precio similar.
Esa verbosidad tiene un impacto directo en el costo real. El precio por token puede parecer moderado, pero si el modelo necesita escribir tres veces más para llegar a la misma respuesta, el costo efectivo por tarea sube. Artificial Analysis calcula ese costo por tarea en $5.98, resultado de multiplicar el precio por token por el volumen real de tokens que el modelo usa para resolver cada evaluación del índice. Te puede servir nuestra cobertura de las capacidades originales de Opus.
Acá está la trampa para quien solo mira el precio por millón de tokens en la web de pricing: pensás que estás pagando poco, hacés el cálculo con tu volumen esperado, subís a producción y el gasto mensual termina siendo mayor al que proyectaste porque el modelo respondió mucho más largo de lo que imaginabas.
¿Cómo rinde Claude Opus 5.5 en programación y tareas agénticas?
Claude Opus 5.5 pasó de 52,3% a 66,4% en Terminal-Bench 4.0 respecto a Opus 5, y de 1.708 a 1.846 Elo en GDPval-AA v2.1, según cifras publicadas por Anthropic y recogidas por WWWhat’s New. En OSWorld 2.0, la prueba de uso de computadora, subió de 74,0% a 81,8%.
Los ejemplos de uso real que documentó Anthropic con sus primeros testers son más concretos que cualquier porcentaje de benchmark: un tester completó una migración de 680.000 líneas de código en menos de un día, trabajo que a un equipo de ingeniería le habría tomado semanas. Otro auditó y reparó una base de código de 200.000 líneas en menos de tres horas, algo que a Opus 5 le había tomado más de 20 horas usando 2,5 veces más tokens.
En la traducción de HAProxy de C a Rust, software crítico de balanceo de carga, Opus 5.5 terminó en 9,5 horas frente a las 12 horas de Fable 5.1, con un costo 51% menor. Deloitte reportó que Opus 5.5 con esfuerzo mínimo detecta el 72% de bugs conocidos en revisiones de código, contra el 56% de Opus 5 en esfuerzo alto.
Ahora bien: esa comparación con Fable 5.1 y con otros modelos de la competencia es una afirmación de Anthropic sobre su propio producto, no una medición independiente de Artificial Analysis. Tomalo con pinzas hasta que aparezcan benchmarks de terceros corriendo las mismas pruebas bajo las mismas condiciones. Más contexto en nuestra guía completa sobre Claude.
¿Qué contexto, modalidades y límites tiene Claude Opus 5.5?
Claude Opus 5.5 tiene una ventana de contexto de 1 millón de tokens, equivalente a unas 1.500 páginas A4 en fuente Arial 12, según Artificial Analysis. Acepta texto e imágenes como entrada y responde solo en texto.
El límite práctico más relevante no es técnico, es de política de uso. Opus 5.5 es el primer modelo Opus que sale con salvaguardas de ciberseguridad y biología equivalentes a las de Fable 5.1: cuando detecta una petición de alto riesgo en esas categorías, redirige la consulta de forma automática a otro modelo (Opus 4.8 para ciberseguridad, Opus 5 para biología) sin que el usuario tenga que reescribir nada, según describe WWWhat’s New.
Para tareas rutinarias de desarrollo, identificar y corregir bugs en código propio, las salvaguardas no intervienen. Es en “la mayoría de tareas de ciberseguridad” donde la redirección opera, según el propio anuncio de Anthropic.
¿Cuánto bajó el precio de Claude Opus 5.5 frente a Opus 5?
El costo total en workloads típicos cae 40% respecto a Opus 5, según Anthropic. La baja más marcada está en las lecturas de caché, que se redujeron 60%, algo relevante porque en pipelines agénticos de larga duración ese rubro concentra la mayor parte del gasto en tokens.
| Concepto | Opus 5.5 | Opus 5 | Diferencia |
|---|---|---|---|
| Tokens de entrada | $4/M | $5/M | -20% |
| Tokens de salida | $20/M | $25/M | -20% |
| Lecturas de caché | $0,20/M | $0,50/M | -60% |
| Escrituras de caché | $5/M | $6,25/M | -20% |
Un pipeline que gastaba 1.000 dólares mensuales en lecturas de caché pasa a gastar 400, sin tocar una línea del workflow, según el cálculo publicado por WWWhat’s New. Box, uno de los primeros testers, encontró que usó un tercio de los tokens de Opus 5 con respuestas 40% menos verbosas y sin pérdida de precisión. Ramp resumió el cambio de estilo con una frase corta: “writes like a good colleague” (escribe como un buen compañero), justo el tipo de feedback que importa en workflows donde alguien tiene que revisar el output antes de publicarlo.
Qué significa para equipos técnicos en Latinoamérica
Si tu equipo ya paga por Opus 5 en producción, el cambio de precios impacta directo en la factura mensual sin que tengas que tocar código. La baja del 60% en cache reads pesa más en agentes de código que corren horas sobre el mismo repositorio que en un chatbot de atención al cliente con conversaciones cortas. Cobertura relacionada: el caso del MCP remoto en Azure DevOps.
Para equipos que despliegan estas integraciones sobre infraestructura propia en la región, la elección del hosting donde corre el backend que llama a la API sigue siendo una decisión aparte de qué modelo uses. Ahí conviene un proveedor confiable como donweb.com antes de sumar cualquier capa de IA sobre un servidor que no aguanta el tráfico.
Esto se conecta con el rendimiento de Claude Opus, donde analizamos las mejoras de velocidad anunciadas por Anthropic.
Qué está confirmado y qué no sobre Claude Opus 5.5
- Confirmado: fecha de lanzamiento (22 de septiembre de 2026), precios de API, score de 58 en el Intelligence Index y ventana de contexto de 1M tokens, todo publicado por Artificial Analysis y Anthropic.
- Confirmado: las salvaguardas de ciberseguridad y biología equivalentes a Fable 5.1, con redirección automática, según el anuncio oficial de Anthropic.
- No confirmado de forma independiente: las comparaciones de rendimiento contra Fable 5.1 y contra modelos de otros laboratorios son afirmaciones de Anthropic sobre su propio producto, todavía sin benchmark de terceros que las replique bajo las mismas condiciones.
- Pendiente: fecha exacta de lanzamiento de Sonnet 5.5 y Haiku 5.5. Anthropic solo confirmó que llegan “en las próximas semanas”, sin fecha concreta hasta el momento.
Errores comunes al evaluar Claude Opus 5.5
- Confundir “Max Effort” con un plan comercial distinto. Es una configuración de razonamiento, no una suscripción aparte ni un producto separado de Opus 5.5.
- Comparar solo el precio por millón de tokens. Con una verbosidad de 260M tokens contra una mediana de 88M, el costo real por tarea ($5.98) puede terminar siendo más alto que el de un modelo con precio nominal mayor pero más conciso.
- Tomar las comparaciones con Fable 5.1 como benchmark neutral. Son casos de uso documentados por Anthropic con sus propios testers, no evaluaciones corridas por un tercero independiente como Artificial Analysis.
- Asumir que las salvaguardas bloquean tareas legítimas de seguridad. Para trabajo rutinario de desarrollo no intervienen; la redirección opera solo en la mayoría de tareas de ciberseguridad de alto riesgo.
Preguntas Frecuentes
¿Cuándo se lanzó Claude Opus 5.5?
Anthropic lanzó Claude Opus 5.5 el 22 de septiembre de 2026, según confirmó Artificial Analysis tras evaluar el modelo. Llegó dos meses después de Opus 5, presentado el 24 de julio de 2026. En la comparativa frente a GLM 5.2 profundizamos sobre esto.
¿Cuánto cuesta usar Claude Opus 5.5 en la API?
Cuesta $4 por millón de tokens de entrada y $20 por millón de salida, con un descuento del 95% en cache hits. El costo por tarea en el Intelligence Index promedia $5.98 por la alta verbosidad del modelo.
¿Qué puntaje tiene Claude Opus 5.5 en los benchmarks de inteligencia?
Anotó 58 puntos en el Artificial Analysis Intelligence Index v4.3.2, contra una mediana de 25 entre modelos de precio comparable. El índice combina 10 evaluaciones, incluyendo Terminal-Bench 4.0, SciCode y Humanity’s Last Exam.
¿Claude Opus 5.5 es más rápido que Opus 5?
Según Anthropic, genera respuestas más de 30% más rápido que Opus 5 en workloads típicos. Artificial Analysis todavía no publicó una medición independiente de tokens por segundo para este modelo (aparece como dato no disponible en su ficha).
¿Qué diferencia hay entre Claude Opus 5.5 y Opus 5?
Opus 5.5 cuesta hasta 40% menos en workloads típicos, sube de 52,3% a 66,4% en Terminal-Bench 4.0 y suma salvaguardas de ciberseguridad y biología equivalentes a las de Fable 5.1 que Opus 5 no tenía.
Conclusión
Claude Opus 5.5 mejora en casi todos los frentes medibles frente a Opus 5: más score en el Intelligence Index, menos precio nominal por token y saltos concretos en benchmarks de código como Terminal-Bench 4.0. El dato que se pierde en los titulares es la verbosidad: con 260 millones de tokens para completar el índice, el costo real por tarea ($5.98) le pone un techo a ese ahorro anunciado del 40%.
Si evaluás migrar de Opus 5 a Opus 5.5, no te quedes con el precio por millón de tokens de la web de pricing. Corré un benchmark propio con tu carga de trabajo real, medí el volumen de tokens que el modelo termina usando y comparalo contra lo que pagás hoy. Ahí vas a ver si el ahorro anunciado se traduce en tu factura o se diluye en respuestas más largas.