
En pocas palabras: Según un desarrollador que lo usa a diario, la industria no se alarma porque asocia calidad con precio alto: DeepSeek V4.1 Flash, lanzado en septiembre de 2026, rinde como un modelo frontier y cuesta USD 0,15 por millón de tokens de entrada (cache miss, fuera de pico).
DeepSeek V4.1 Flash es un modelo MoE abierto de 552B parámetros que DeepSeek presentó en septiembre de 2026, con 1M de tokens de contexto y entrada desde USD 0,15 por millón de tokens fuera de horario pico (cache miss).
DeepSeek V4.1 Flash es un modelo de lenguaje con arquitectura Causal Encoder-Decoder, comprensión visual nativa y pesos publicados en Hugging Face. En la API se llama deepseek-flash y reemplaza a V4-Flash y V4-Flash-Vision-Exp. Su foco es bajar el costo del caché, que según DeepSeek pesa mucho en la factura de los agentes. Lo nuevo hoy es la reacción de un desarrollador que lo usa a diario, no el lanzamiento.
En este artículo:
- En 30 segundos
- ¿Qué es DeepSeek V4.1 Flash y cuándo salió?
- ¿Cómo reduce DeepSeek V4.1 Flash el costo del KV cache?
- ¿DeepSeek V4.1 Flash rinde como un modelo frontier como Opus?
- ¿Cuánto cuesta usar DeepSeek V4.1 Flash en una sesión larga de programación?
- ¿Qué pasó con DeepSeek V4 Pro?
- ¿Conviene autoalojar DeepSeek V4.1 Flash?
- ¿Por qué la industria no se alarma por DeepSeek V4.1 Flash?
- ¿Qué está confirmado y qué no sobre DeepSeek V4.1 Flash?
- ¿Cómo verificar si DeepSeek V4.1 Flash te sirve?
- Errores comunes
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- DeepSeek V4.1 Flash tiene 552B parámetros, con 8B activos en la entrada y 16B en la salida, y contexto de 1M de tokens.
- Cuesta USD 0,003 por millón de tokens en cache hit, USD 0,15 en cache miss y USD 0,60 de salida fuera de pico. En pico, el doble.
- Según DeepSeek, su KV cache usa 1/4 de la HBM y 1/8 del SSD de la generación anterior.
- V4-Pro se retira: desde el 14/9/2026 sus requests van a V4.1-Flash, a tarifa Flash.
- Que rinda como Opus es la impresión de un solo usuario, sin benchmark independiente en las fuentes.
¿Qué es DeepSeek V4.1 Flash y cuándo salió?
DeepSeek V4.1 Flash es el modelo más chico de la nueva familia de arquitectura de DeepSeek. Los precios nuevos rigen desde las 04:00 UTC del 10 de septiembre de 2026 y la dirección del anuncio oficial lleva esa misma fecha. Tiene 552B parámetros en total, pero activa solo 8B para procesar la entrada y 16B para generar la salida.
La página de precios suma el resto de la ficha: 1M de tokens de contexto, salida máxima de 384K, modo con y sin razonamiento (con razonamiento por defecto), tool calls, salida JSON y visión. Los pesos están en Hugging Face. Los nombres viejos deepseek-v4-flash y deepseek-v4-flash-vision-exp siguen funcionando, pero esos modelos están retirados y responde V4.1-Flash.
El blog que dispara esta nota es del 7 de octubre de 2026, casi un mes después del lanzamiento. La novedad es el uso intensivo de alguien que lo probó un mes, y eso conviene leerlo como testimonio, no como noticia de producto.
¿Cómo reduce DeepSeek V4.1 Flash el costo del KV cache?
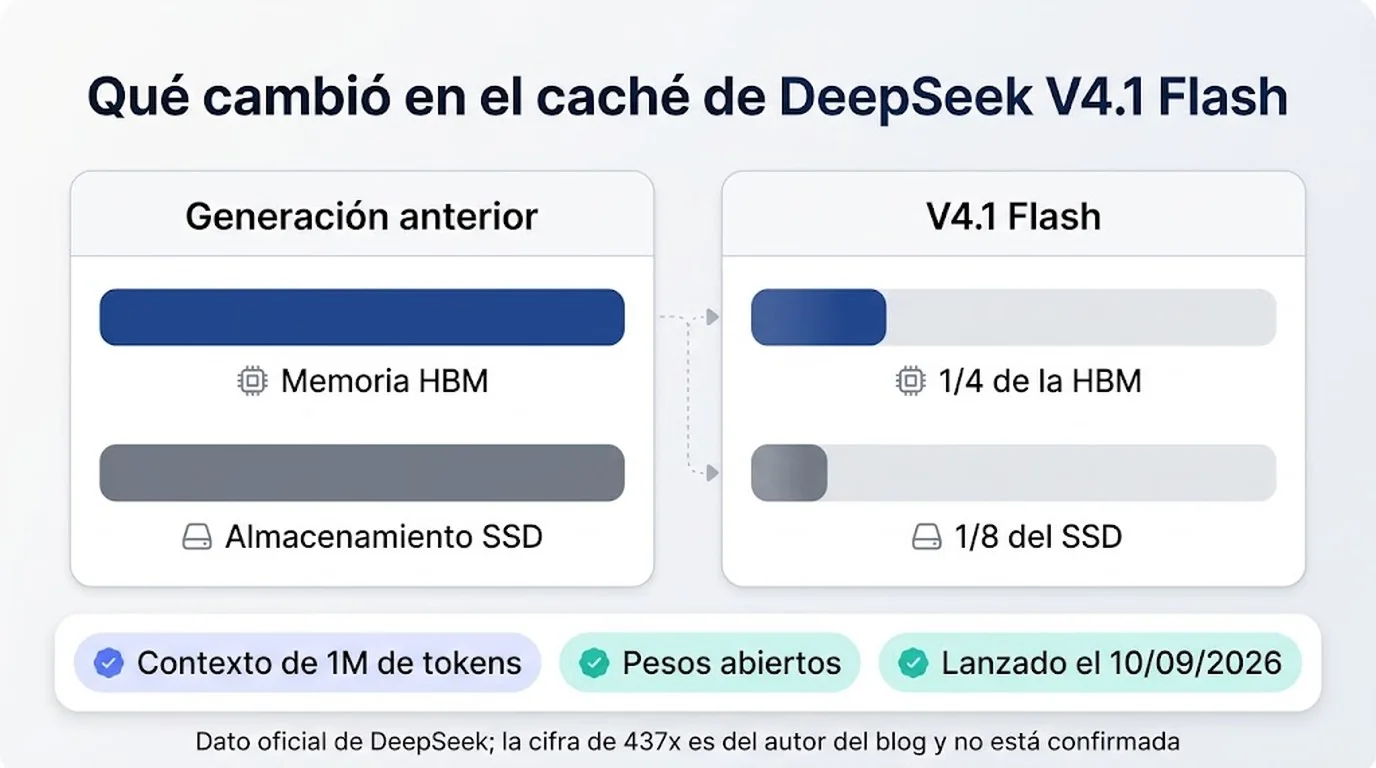
Según DeepSeek, el KV cache de V4.1 Flash necesita un cuarto de la memoria HBM y un octavo del almacenamiento SSD que la generación anterior. El KV cache es la memoria donde el modelo guarda lo ya procesado del contexto para no recalcularlo en cada turno, y en sesiones largas de código crece con cada mensaje.
- Un cuarto de la HBM. Es la memoria de la GPU, la más cara de la cadena, y la que limita cuántas sesiones largas atiende cada máquina.
- Un octavo del SSD. El caché que no entra en GPU se guarda en disco, y ese almacenamiento también se achicó.
- Efecto en la factura. DeepSeek explica que los cargos por cache hit suelen ser una parte grande del costo de los agentes, así que comprimir el caché los baja de forma significativa.
El autor del blog habla de una reducción de unas 437 veces frente al modelo V1. Ese número no aparece en el anuncio, que compara contra la generación anterior, así que tomalo como cifra del autor sin verificar. Existe además un paper en arXiv titulado “DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression”, pero el texto que pudimos leer del PDF no permite describir sus técnicas, y no vamos a inventarlas.
¿DeepSeek V4.1 Flash rinde como un modelo frontier como Opus?
Las fuentes no traen ningún benchmark independiente que lo confirme. Lo que hay es la impresión de un desarrollador y una afirmación de DeepSeek. El autor del blog dice que lo usa desde hace un mes en una docena de proyectos y que, a mitad de sesión, no podría decir “con honestidad si estoy usando DeepSeek u Opus” (traducción nuestra del original en inglés).
DeepSeek, por su parte, afirma que pruebas “de múltiples partes” ponen a V4.1-Flash por delante de V4-Pro en rendimiento, costo, velocidad y tiempo total. El anuncio no nombra a esas partes ni da cifras. La comparación es contra el propio V4-Pro, no contra Opus. Más contexto en la enorme brecha de costo frente a otros modelos.
Ahora bien, el mismo autor sigue llamando a Opus 5.5 para la revisión final de código, donde según él detecta algunos casos borde, y después le pasa las correcciones a DeepSeek. También reconoce que los laboratorios de Anthropic y OpenAI pueden estar uno o dos meses adelante.
Mi lectura: es un caso individual, subjetivo, sin método y sobre sus propios proyectos (un solo usuario, ojo). Sirve como señal para probarlo, no como razón para sacar la revisión con un modelo más caro.
¿Cuánto cuesta usar DeepSeek V4.1 Flash en una sesión larga de programación?
Según la página oficial de precios, el millón de tokens de deepseek-flash cuesta entre USD 0,003 y USD 1,20 según el tipo de token y el horario. El valle (off-peak) vale la mitad que el pico.
- Entrada con cache hit: USD 0,003 en valle y USD 0,006 en pico.
- Entrada con cache miss: USD 0,15 en valle y USD 0,30 en pico.
- Salida: USD 0,60 en valle y USD 1,20 en pico.
El pico va de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes y sin contar feriados chinos. En hora argentina (UTC-3, conversión nuestra) son de 22:00 a 01:00 y de 03:00 a 07:00. Una jornada de 9 a 18 en Argentina cae entera en valle, aunque conviene chequear cómo se corta el día al cruzar la medianoche UTC.
El autor del blog dice que rara vez superó el equivalente a USD 1 por sesión, incluso en sesiones de casi un día entero, y que ordenar los archivos del escritorio le costaría USD 0,003 contra USD 1 en un modelo frontier. Ese cálculo sale de su plan OpenCode Go, de USD 10 al mes, que es de un intermediario y no un plan de DeepSeek. Por eso habla de costos “esperados”, que son estimaciones y no una factura. Ya lo cubrimos antes en cómo se compara con los modelos de Google.
Un ejemplo hipotético, armado con la tabla de precios y no medido: una sesión con 20M de tokens de entrada en cache hit, 1M en cache miss y 0,5M de salida cuesta USD 1,02 en pico (0,12 + 0,30 + 0,60) y USD 0,51 en valle. La salida pesa más que todo el contexto repetido, porque el caché barato solo ayuda si tu flujo reutiliza el prefijo.
¿Qué pasó con DeepSeek V4 Pro?
DeepSeek lo está retirando. Según el anuncio, desde las 04:00 UTC del 14 de septiembre de 2026 todas las requests a deepseek-v4-pro se rutean a V4.1-Flash, a tarifa de Flash, hasta que salga V4.1-Pro. El autor del blog dice que no le importa que no exista un 4.1 Pro.
Hay una inconsistencia para revisar: la página de precios todavía lista deepseek-v4-pro (versión DeepSeek-V4-Pro-0813) con tarifas propias, como USD 0,66 por millón de entrada en cache miss en valle, y un límite de concurrencia de 500 contra 2500 de Flash. Si usás ese nombre, mirá en tu consumo qué modelo respondió y a qué precio te cobraron.
¿Conviene autoalojar DeepSeek V4.1 Flash?
Para casi nadie. Los pesos son abiertos, pero el modelo tiene 552B parámetros, y el autor del blog dice que es autoalojable en lo técnico y no en lo práctico. Si tu objetivo es ahorrar, afirma que nunca recuperás la inversión. DeepSeek mismo habla de despliegues de 2.000 GPUs más un clúster de almacenamiento.
Para la privacidad el panorama es otro. El autor espera que estas optimizaciones de caché lleguen pronto a ejecución local, y DeepSeek dice que va a trabajar con la comunidad open source en soporte de inferencia. Ambas cosas son expectativas, no hechos. Tema relacionado: la comparativa entre OpenAI y DeepSeek.
Lo que sí tiene sentido alojar es la parte común: el backend que llama a la API cabe en un VPS o cloud como los de donweb.com. El modelo no entra ahí.
¿Por qué la industria no se alarma por DeepSeek V4.1 Flash?
Es la opinión del autor, no un dato. Él sostiene que las grandes tecnológicas piensan que lo que no cuesta caro no vale, y que ese incentivo de gasto las deja mirando para otro lado mientras modelos chinos destilados cubren las mismas cargas de trabajo.
Las fuentes no miden ninguna reacción de Anthropic u OpenAI, así que no hay forma de saber si “no se alarman” es cierto. Hay una lectura más simple, que es mía: si hasta el propio autor recurre a Opus para la revisión final, el segmento caro sigue teniendo comprador.
¿Qué está confirmado y qué no sobre DeepSeek V4.1 Flash?
- Confirmado por DeepSeek: 552B parámetros, 8B activos de entrada y 16B de salida, KV cache con 1/4 de HBM y 1/8 de SSD, precios con descuento del 50% en valle, V4-Pro ruteado a Flash desde el 14/9/2026.
- Afirmado sin detalle: que pruebas de terceros lo ponen por delante de V4-Pro (no nombra quién ni cuánto).
- Opinión de un usuario: que se comporta como Opus, que las sesiones salen menos de USD 1 y que la industria debería preocuparse.
- Sin verificar: la reducción de 437x del caché y que la ejecución local llegue pronto.
- Pendiente: la fecha de V4.1-Pro, que el anuncio no da.
¿Cómo verificar si DeepSeek V4.1 Flash te sirve?
Una propuesta editorial, que no sale de las fuentes ni la probamos nosotros: armá tu propia prueba corta con tareas reales.
- Elegí 20 tareas de tu repo que ya resolvió tu modelo actual, con resultado conocido.
- Corré las mismas con
deepseek-flashy el mismo prompt, y comparalas a ciegas con revisión humana. - Anotá el costo por tarea con el detalle de tokens que muestre tu proveedor, separando cache hit, cache miss y salida.
- Repetí en pico y en valle para ver cuánto cambia la factura con tu patrón de uso.
Si tus tareas son repetitivas, con contexto largo y poco riesgo, el resultado va a decirte más que cualquier blog. Si son críticas, dejá la revisión final con el modelo que hoy te da confianza.
Errores comunes
- Tratar un testimonio como benchmark. Un mes de uso de una persona no reemplaza una evaluación con tus tareas. Corrección: usá la prueba de arriba.
- Calcular con el precio del cache hit. USD 0,003 es el piso, no el promedio. Corrección: sumá cache miss y salida, que fue la mayor parte de la cuenta en el ejemplo.
- Confundir el plan de un intermediario con la API. Los USD 10 al mes de OpenCode Go no son tarifa de DeepSeek. Corrección: compará con los precios por millón de tokens de la página oficial.
- Seguir creyendo que usás V4 Pro. Si apuntás a
deepseek-v4-pro, la documentación dice que responde V4.1-Flash. Corrección: pasate adeepseek-flashy verificá en tu consumo. - Leer “pesos abiertos” como “lo corro en mi PC”. Con 552B parámetros no es el caso. Corrección: usá la API hasta que haya soporte de inferencia local confirmado.
Preguntas Frecuentes
¿Qué es DeepSeek V4.1 Flash?
Es un modelo MoE de DeepSeek con 552B parámetros, de los cuales activa 8B en la entrada y 16B en la salida. Tiene visión nativa, 1M de tokens de contexto y pesos abiertos en Hugging Face. En la API se usa con el nombre deepseek-flash. Te puede servir nuestra cobertura de formas reales de probarlo sin pagar.
¿Cuándo salió DeepSeek V4.1 Flash?
DeepSeek lo anunció en septiembre de 2026: sus precios nuevos rigen desde las 04:00 UTC del 10 de septiembre. La dirección del anuncio oficial también lleva esa fecha (260910).
¿Por qué DeepSeek V4.1 Flash es tan barato?
Según DeepSeek, su KV cache necesita 1/4 de la HBM y 1/8 del SSD de la generación anterior, y eso le permite atender más usuarios a menor costo. El precio parte de USD 0,003 por millón de tokens en cache hit fuera de pico, y la salida cuesta USD 0,60 en valle.
¿DeepSeek V4.1 Flash es tan bueno como Claude Opus?
No está demostrado. Un desarrollador dice que no nota diferencia con Opus tras un mes de uso, pero es una impresión subjetiva, y él mismo sigue usando Opus 5.5 para revisiones finales. DeepSeek solo afirma que supera a V4-Pro.
¿Se puede instalar DeepSeek V4.1 Flash en mi propia computadora?
Los pesos son abiertos, pero con 552B parámetros no es práctico en una computadora personal. El autor del blog lo considera autoalojable en lo técnico y no en lo práctico, y DeepSeek habla de despliegues de 2.000 GPUs más un clúster de almacenamiento.
Conclusión
Lo comprobado es acotado y bueno: un modelo abierto con caché mucho más liviano, precios publicados y un V4-Pro que pasa a responder con Flash. Lo no comprobado es lo que mueve la discusión, que rinda como Opus y que la industria deba alarmarse.
Qué hacer: probalo con tus tareas repetitivas, medí costo y calidad en pico y en valle, y verificá qué modelo te responde si todavía apuntás a V4 Pro. Dejá la revisión crítica con tu modelo de confianza hasta tener datos propios.