
En pocas palabras: llm-d 1.0 es el stack open source de inferencia distribuida para LLMs sobre Kubernetes que Red Hat, IBM, Google Cloud, CoreWeave y NVIDIA lanzaron el 20 de octubre de 2026 bajo la gobernanza de la CNCF, con reducciones de costo de hasta 10 veces —y hasta 11,5 veces en un caso de IBM Research— para cargas agentic y RAG en producción.
llm-d 1.0 es el proyecto open source que Red Hat, IBM, Google Cloud, CoreWeave y NVIDIA presentaron el 20 de octubre de 2026 bajo la gobernanza de la Cloud Native Computing Foundation (CNCF). La promesa central: bajar hasta 10 veces el costo de inferencia de modelos de lenguaje en producción, con un caso de IBM Research que llegó a 11,5 veces menos costo frente a una configuración 100% propietaria.
llm-d 1.0 es un stack de inferencia distribuida para LLMs que corre sobre Kubernetes y orquesta motores de servidor de modelos como vLLM y SGLang a través de múltiples nodos. Lo construyó un consorcio fundado en 2025 por Red Hat, IBM Research, Google Cloud, CoreWeave y NVIDIA, donado luego a la CNCF. Sirve para escalar cargas agentic y RAG sin que el costo por token se dispare a medida que crece la demanda.
En este artículo:
- En 30 segundos
- ¿Qué problema de inferencia LLM en producción resuelve llm-d 1.0?
- ¿Quiénes están detrás del lanzamiento de llm-d 1.0 y cuándo se anunció?
- ¿Cómo funciona la arquitectura de llm-d 1.0: Router, InferencePool y Model Server?
- ¿Cuánto reduce los costos de inferencia llm-d 1.0 según los datos disponibles?
- ¿Qué limitaciones y requisitos tiene adoptar llm-d 1.0 en producción?
- Comparativa de resultados reportados con llm-d 1.0
- ¿Qué está confirmado y qué queda por verificar en llm-d 1.0?
- Errores comunes al evaluar llm-d 1.0
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- llm-d 1.0 se anunció el 20 de octubre de 2026, con más de 500 contribuyentes de 25+ organizaciones según el comunicado de Red Hat.
- Google Cloud anunció en su blog oficial, el 24 de marzo de 2026, que llm-d fue aceptado como proyecto CNCF Sandbox.
- IBM Research reportó 11,5 veces menos costo de inferencia usando llm-d con modelos open frontier, con un hit rate de prefix-cache de aproximadamente 98%.
- La arquitectura central combina Router, InferencePool y Model Server, con un Endpoint Picker (EPP) que decide a qué pod mandar cada request.
- En un benchmark con GLM 5.2 (753.000 millones de parámetros), llm-d sirvió hasta 3.000 agentes de código concurrentes con cero preemptions.
¿Qué problema de inferencia LLM en producción resuelve llm-d 1.0?
llm-d 1.0 resuelve el cuello de botella de servir LLMs a múltiples usuarios con cargas agentic y RAG que generan picos impredecibles, algo que rompe los patrones estándar de microservicios porque la inferencia es stateful y encarece el cómputo a medida que sube la demanda, según describe el análisis publicado en dev.to.
Ponele que tenés una plataforma de agentes de código corriendo RAG sobre tu base de conocimiento interna. Un agente dispara diez sub-tareas en paralelo, cada una reconstruye el mismo contexto desde cero, la GPU se satura y los usuarios interactivos (los que están esperando una respuesta en tiempo real) quedan en cola detrás de ese tráfico bursty. Ese es, puntualmente, el escenario que llm-d intenta ordenar: priorizar lo urgente sin matar de hambre a nadie.
El tema es que gestionar ese contexto consume más recursos que generar la respuesta final. Eso convierte la memoria y el reuso de caché en el factor que define si tu AI es rentable o no. Más contexto en nuestra nota sobre si usás Gemini en tus pipelines.
¿Quiénes están detrás del lanzamiento de llm-d 1.0 y cuándo se anunció?
Red Hat, IBM, Google Cloud, CoreWeave y NVIDIA son los contribuyentes fundadores que anunciaron llm-d 1.0 el 20 de octubre de 2026, según el comunicado oficial de Red Hat. El proyecto nació en 2025 y hoy lo gobierna la CNCF.
El 24 de marzo de 2026, Google Cloud anunció en su blog oficial que llm-d fue aceptado formalmente como proyecto CNCF Sandbox, el nivel inicial de madurez de esa fundación, no el máximo, y aclaró que la gobernanza queda bajo el paraguas de la Linux Foundation. Chris Aniszczyk, CTO de la CNCF, lo resumió así: “AI inference is quickly becoming a core cloud native workload. llm-d 1.0 helps organizations meet this shift at scale”.
AMD, Cohere, DigitalOcean y JetBrains también aparecen como colaboradores activos en el anuncio de octubre, lo que suma otro dato: el proyecto ya no es solo “los cinco fundadores” sino un ecosistema con más de 500 contribuyentes de más de 25 organizaciones.
¿Cómo funciona la arquitectura de llm-d 1.0: Router, InferencePool y Model Server?
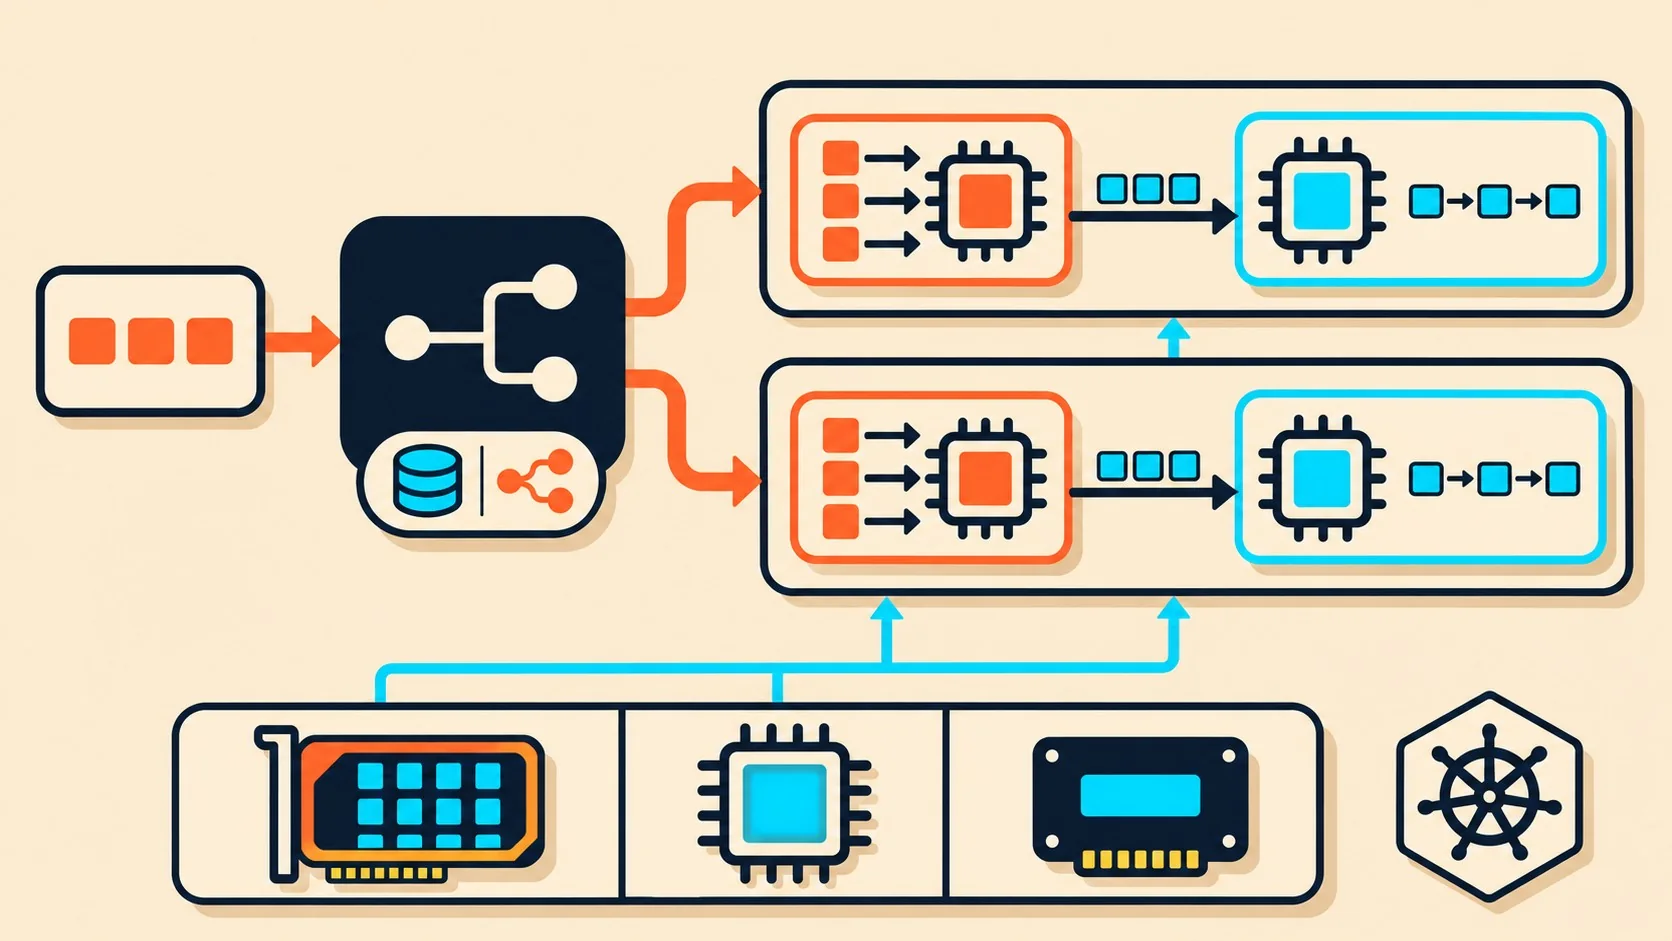
La arquitectura de llm-d 1.0 se apoya en tres piezas: el Router, que recibe y balancea los pedidos de inferencia; el InferencePool, que agrupa los recursos de cómputo disponibles; y el Model Server, que corre el modelo en sí (vLLM, SGLang u otro motor). El Endpoint Picker (EPP) dentro del Router puntúa cada pod según métricas en tiempo real y afinidad de KV-cache, según el análisis de dev.to.
Acá viene lo bueno: el ecosistema de KV-cache incluye ruteo consciente de prefix-cache para maximizar hits, indexado para rastrear el estado del caché y offloading a almacenamiento en capas (CPU, SSD) para extender capacidad sin comprar más GPU. Para tráfico que tolera latencia, el componente llm-d-async-processor rutea pedidos desde colas junto al tráfico en tiempo real, usando gates de cola y de despacho para hacer cumplir prioridades y cuotas.
¿Y el escalado? Soporta autoscaling proactivo basado en SLO usando KEDA y métricas del EPP, que siguen señales como profundidad de cola y backlog de tokens. También maneja “serving disagregado”: divide un pedido en fases (prefill y decode) que corren en workers especializados, orquestados por el Router. Esa separación evita que los loops bursty de los agentes le roben recursos a los usuarios interactivos. Profundizamos sobre esto en nuestra nota sobre cómo armar un sistema con failover entre proveedores.
¿Cuánto reduce los costos de inferencia llm-d 1.0 según los datos disponibles?
llm-d 1.0 reporta reducciones de costo de 5 a 10 veces frente a configuraciones completamente propietarias en algunos casos de uso, y hasta 11,5 veces en el caso específico de IBM Research, según el comunicado de Red Hat.
En ese caso, IBM usó modelos open frontier para explorar hardware de corrección cuántica de errores, con un hit rate de prefix-cache de aproximadamente 98% y un costo de serving combinado de unos USD 0,11 por millón de tokens. En un benchmark separado, el equipo desplegó GLM 5.2, un modelo open-weight de aproximadamente 753.000 millones de parámetros, sobre GPUs NVIDIA ampliamente disponibles. Con cientos de sesiones agentic corriendo en paralelo, la implementación entregó más de 6,6 millones de tokens de salida por minuto en pico, sirviendo hasta 3.000 agentes de código concurrentes sin ninguna preemption.
¿Alguien lo verificó de forma independiente? Hasta el 2026-11-06 no hay una auditoría externa publicada. Son cifras que reportan los propios contribuyentes del proyecto, así que tomalas con pinzas: son benchmarks de parte interesada, no un paper con revisión por pares.
¿Qué limitaciones y requisitos tiene adoptar llm-d 1.0 en producción?
Adoptar llm-d 1.0 exige equipo con experiencia en Kubernetes, porque el proyecto es nativo de esa plataforma y usa custom resources, orquestación y prácticas cloud-native que no son triviales para alguien que nunca tocó un cluster.
El análisis de dev.to lo plantea sin vueltas: adoptar llm-d requiere configuración cuidadosa, entendimiento de su arquitectura e integración con tus pipelines existentes de CI/CD y monitoreo; no es un “magic bullet” que elimine toda la complejidad operativa. Tema relacionado: montar un cluster casero para inferencia.
Para equipos con volumen bajo de inferencia, el overhead de montar una red de inferencia distribuida puede superar el ahorro de usar una API gestionada más simple. Los beneficios grandes aparecen en organizaciones con cargas diversas y crecientes, no en un side project con cuatro requests por minuto. Si tu necesidad real es alojamiento web tradicional (sitios, dominios, VPS) y no un cluster de inferencia LLM, un proveedor como donweb.com resuelve eso sin que tengas que meterte en Kubernetes para nada.
Comparativa de resultados reportados con llm-d 1.0
| Caso de uso | Modelo / contexto | Resultado reportado |
|---|---|---|
| IBM Research (hardware cuántico) | Modelos open frontier | 11,5x menos costo, prefix-cache hit ~98%, USD 0,11 por millón de tokens |
| Benchmark agentic coding | GLM 5.2 (753B parámetros) en GPUs NVIDIA | 6,6M tokens/min en pico, 3.000 agentes concurrentes, cero preemptions |
| GKE Inference Gateway (Vertex AI) | Qwen Coder / DeepSeek | TTFT -35%, latencia P95 -52%, prefix cache hit de 35% a 70% |
¿Qué está confirmado y qué queda por verificar en llm-d 1.0?
Está confirmado: la fecha de anuncio (20 de octubre de 2026), las empresas fundadoras, la aceptación en CNCF Sandbox y los componentes de arquitectura (Router, InferencePool, Model Server, EPP). Eso surge directamente de los comunicados oficiales de Red Hat, IBM y Google Cloud.
Lo que no queda claro: si las cifras de 5 a 10 veces de ahorro se sostienen fuera de los benchmarks controlados de los propios contribuyentes. No hay, por ahora, un reporte independiente que replique esos números en un entorno de producción ajeno a IBM, Red Hat o Google Cloud. Lo complementamos en revisar las dependencias antes de desplegar.
Errores comunes al evaluar llm-d 1.0
- Pensar que llm-d reemplaza a vLLM o SGLang. No lo hace: los orquesta. llm-d corre por encima de esos motores de servidor, no en su lugar.
- Subestimar la curva de Kubernetes. Si tu equipo nunca manejó CRDs ni operadores, la adopción va a tomar semanas, no un fin de semana.
- Asumir que el ahorro de 5-10x aplica a cualquier volumen. Los casos reportados son de cargas grandes y sostenidas, no de un proyecto chico con tráfico esporádico.
- Confundir CNCF Sandbox con proyecto graduado. Sandbox es el escalón inicial de madurez de la CNCF, no el nivel máximo (ese sería “Graduated”).
Preguntas Frecuentes
¿Qué es llm-d 1.0?
llm-d 1.0 es un stack de inferencia distribuida para LLMs, nativo de Kubernetes, que orquesta motores de servidor como vLLM y SGLang en múltiples nodos. Lo anunciaron Red Hat, IBM, Google Cloud, CoreWeave y NVIDIA el 20 de octubre de 2026 bajo gobernanza de la CNCF.
¿Quién desarrolló llm-d 1.0?
El proyecto lo fundaron en 2025 Red Hat, IBM Research, Google Cloud, CoreWeave y NVIDIA. Hoy lo gobierna la Cloud Native Computing Foundation, con más de 500 contribuyentes de más de 25 organizaciones, entre ellas AMD, Cohere, DigitalOcean y JetBrains. Para más detalles técnicos, mirá correr modelos locales de forma segura.
¿Cómo reduce costos llm-d la inferencia de LLM?
Reduce costos sobre todo con reuso de KV-cache (prefix-cache routing y offloading a CPU/SSD) y serving disagregado entre prefill y decode. IBM Research reportó hasta 11,5 veces menos costo frente a una configuración 100% propietaria.
¿Qué es el CNCF Sandbox y por qué llm-d está ahí?
El CNCF Sandbox es el nivel de madurez inicial dentro de la Cloud Native Computing Foundation, pensado para proyectos tempranos que todavía no acumularon el track record para pasar a “Incubating” o “Graduated”. Google Cloud anunció la aceptación de llm-d en ese nivel el 24 de marzo de 2026.
¿llm-d es compatible con vLLM?
Sí, llm-d es compatible con vLLM y también con SGLang como motores de servidor de modelos. El proyecto se describe a sí mismo como engine-agnostic y hardware-agnostic, corriendo sobre NVIDIA, AMD y aceleradores personalizados según su documentación oficial.
Conclusión
llm-d 1.0 pasa de ser un experimento de 2025 a un release que sus propios creadores llaman “validado para Day-2 production”. Si manejás agentes o RAG a escala y ya pensás en Kubernetes, vale la pena mirarlo de cerca, aunque las cifras de ahorro las publiquen quienes construyeron el proyecto. Si tu carga es chica o tu equipo todavía no domina orquestación cloud-native, probablemente te convenga esperar a ver reportes independientes antes de migrar tu stack de inferencia.