En pocas palabras: Ubicloud lo resolvió activando constrained decoding en vLLM 0.31 mediante las structural tags de XGrammar. Así pasó de 92% a 100% de precisión de esquema en tool calling con Kimi K2.6 y DeepSeek, según el benchmark K2VV ToolCall de Moonshot AI.
Ubicloud confirmó que servir Kimi K2.6 con vLLM 0.28 daba solo 92% de precisión de esquema en tool calling: 2 de cada 25 llamadas fallaban. Después de activar constrained decoding en vLLM 0.31 mediante las structural tags de XGrammar, la empresa llegó a 100% de precisión de tool calling en el benchmark K2VV ToolCall de Moonshot AI, tanto para Kimi como para DeepSeek.
La precisión de esquema (schema accuracy) en tool calling es la métrica que mide qué fracción de las llamadas a herramientas generadas por un modelo cumple el JSON schema definido por esa herramienta, lo que permite ejecutarlas sin errores. El constrained decoding es la técnica que vLLM usa, vía la librería XGrammar, para restringir token por token lo que el modelo puede generar y así garantizar esa validez en tiempo de ejecución.
En este artículo:
- En 30 segundos
- ¿Qué es un tool call y por qué su esquema debe ser exacto?
- ¿Por qué fallan los tool calls en los modelos open-weight?
- ¿Qué mostró el benchmark K2VV ToolCall de Moonshot AI sobre la precisión de tool calling en vLLM?
- ¿Cómo funciona el constrained decoding en vLLM con XGrammar?
- ¿Por qué vLLM mantiene el constrained decoding desactivado por defecto?
- ¿Cómo se activa el constrained decoding en vLLM 0.31 y qué resultados da?
- Comparativa: accuracy según configuración de vLLM
- Errores comunes al configurar tool calling en vLLM
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Con vLLM 0.28 y constrained decoding desactivado, Kimi K2.6 solo alcanzaba 92% de schema accuracy en el benchmark K2VV ToolCall.
- vLLM agregó la flag
--tool-strict-levelen la versión 0.31 para activar constrained decoding por modelo sin romper la compatibilidad general. - Ubicloud reportó 100% de precisión tool calling vLLM en Kimi y DeepSeek tras activar la flag y re-correr el benchmark de Moonshot AI.
- vLLM mantiene constrained decoding desactivado por default porque rompe a modelos como gpt-oss-20b, Qwen 3.6 y GLM 5.1.
- Un equipo que migró Qwen2.5-7B-Instruct a self-host reportó una caída a 70% de accuracy en producción por usar el parser equivocado, y subió a más de 97% corrigiendo la configuración del servidor.
¿Qué es un tool call y por qué su esquema debe ser exacto?
Un tool call es la estructura JSON que un modelo genera para pedirle a tu agente que ejecute una función externa, y tiene que cumplir el schema exacto de esa función o el parser no la puede ejecutar. El flujo tiene dos pasos: primero el harness le informa al modelo qué herramientas existen, después el modelo tiene que devolver una llamada que respete esa definición.
Ponele que estás usando OpenCode conectado a Kimi. OpenCode le manda al modelo un array JSON con las herramientas disponibles, y una de ellas es webfetch, que trae el contenido de una URL. Esa definición incluye parámetros como url (obligatorio), format (con un enum de text, markdown o html) y un timeout opcional. El motor de inferencia envuelve esta definición en tokens específicos del modelo, en el caso de Kimi algo como <|im_system|>tool_declare<|im_middle|>, para que el modelo reconozca que ahí hay herramientas disponibles.
Cuando el usuario pide fetchear una página, el modelo genera texto con tokens especiales como <|tool_calls_section_begin|> seguidos de los argumentos en JSON. El parser del servidor de inferencia extrae esos tokens y arma un objeto tool_calls con name y arguments, que vuelve al harness para ejecutarse de forma real. Si en algún punto de esa cadena el JSON no respeta el schema, ya sea porque falta un campo requerido o porque el tipo no coincide, la ejecución se rompe ahí.
¿Por qué fallan los tool calls en los modelos open-weight?
Los tool calls fallan porque un modelo de lenguaje genera tokens según probabilidad, no según reglas de sintaxis, y nada le impide producir un JSON mal formado aunque el prompt sea claro. No es un compilador ni un type checker: elige el siguiente token por muestreo ponderado, y ese muestreo puede equivocarse incluso cuando el esquema está bien documentado. Para más detalles técnicos, mirá el tool calling en paralelo de GPT-Realtime-2.
El problema de fondo es el desfasaje entre los datos de entrenamiento y el esquema real en producción. Los modelos se entrenan con muchos datasets de tool calling, cada uno con sus propios nombres de herramientas y convenciones. Entonces el modelo puede generar un nombre que vio durante el entrenamiento aunque no exista en tu entorno actual: pedís web_search y te devuelve search_web, o esperás el campo location y te llega city_name. El modelo no está “mintiendo”: está completando el patrón más probable según lo que vio antes, que no necesariamente coincide con tu schema.
Hay otro factor que complica el panorama. Según un desarrollador que migró un agente interno de una API comercial a vLLM self-hosted con Qwen2.5-7B-Instruct, usar el parser equivocado para la familia del modelo lleva la accuracy directo al piso: Qwen y Hermes usan el tag <tool_call>, Llama 3.x usa un formato JSON propio, Mistral usa el token [TOOL_CALLS]. Si configurás --tool-call-parser llama3_json para servir Qwen2.5, el parser nunca va a matchear y todas las llamadas van a terminar como texto plano en el campo content.
¿Qué mostró el benchmark K2VV ToolCall de Moonshot AI sobre la precisión de tool calling en vLLM?
El benchmark K2VV ToolCall de Moonshot AI mostró que servir Kimi K2.6 con vLLM 0.28 daba 92% de schema accuracy, es decir que 2 de cada 25 tool calls generadas fallaban al no cumplir el esquema. Moonshot AI publicó este benchmark para que cualquier proveedor pueda verificar si sirve a Kimi con la misma calidad que el servicio original de la compañía.
El workload del benchmark consiste en 2000 requests diseñadas para evaluar dos cosas: cuándo el modelo decide disparar una llamada a herramienta, y si esa llamada es sintácticamente correcta. De ahí salen dos métricas. La trigger similarity mide cuán parecidas son las decisiones de disparo del servicio evaluado respecto al servicio propio de Moonshot AI. La schema accuracy cuantifica qué fracción de las llamadas generadas respeta el schema de la herramienta y puede invocarse sin romperse, según detalla el blog técnico de Ubicloud publicado el 20 de octubre de 2026.
Cuando la schema accuracy cae al 50%, la mitad de las llamadas que el modelo intenta generar son inválidas. Eso no es un detalle menor en workloads agénticos: cada llamada fallida obliga al agente a reintentar, infla el contexto con mensajes de error y te sube el costo en tokens sin necesidad.
¿Cómo funciona el constrained decoding en vLLM con XGrammar?
El constrained decoding en vLLM funciona restringiendo, en cada paso de generación, el conjunto de tokens que el modelo puede muestrear, de forma que solo queden habilitados los que mantienen la llamada dentro del schema válido. En vez de dejar que el modelo genere libremente y validar el resultado después, el motor guía la generación paso a paso usando structural tags de la librería XGrammar. Sobre eso hablamos en el costo real de desplegar DeepSeek-V3 en vLLM.
Para Kimi K2.6, XGrammar define el camino válido con un TagFormat que especifica dónde empieza la llamada, dónde aparece el índice de la herramienta, dónde empiezan los argumentos y dónde el JSON restringido por schema tiene que generarse. El camino completo queda así: comienzo de la llamada, nombre de la herramienta, índice numérico, comienzo de argumentos, JSON restringido por schema, y fin de la llamada. Cuando la generación llega a la fase del índice, el motor restringe el muestreo solo a tokens numéricos y enmascara todo lo demás, repitiendo esa lógica en cada fase.
Lo interesante es que este enmascaramiento no te cuesta performance de forma significativa. XGrammar precomputa las máscaras de tokens para cada fase y las aplica de forma eficiente en la GPU durante la generación, así que convertís la schema accuracy de un best-effort probabilístico a una garantía en tiempo de ejecución, sin pagar un costo de latencia relevante por eso.
¿Por qué vLLM mantiene el constrained decoding desactivado por defecto?
vLLM mantiene el constrained decoding desactivado por defecto porque, al ser un motor diseñado para servir una variedad enorme de modelos, forzar esta técnica en todos rompe a algunos de ellos. Ubicloud identifica tres categorías de problemas:
- Problemas generales del modelo: en algunos casos el output sin restricciones diverge tanto del schema o del formato de tool-calling propio del modelo que forzarlo hacia tokens válidos lo desvía por completo. Usuarios reportaron este tipo de fallas con gpt-oss-20b, Qwen 3.6 y GLM 5.1 cuando la feature venía activada por default.
- Bugs de traducción de grammar: vLLM puede tener errores al traducir el schema o el formato de tool-calling de un modelo a su grammar específica, lo que genera llamadas inválidas, fallos de request o una degradación silenciosa del constrained decoding sin que nadie se entere.
- Bugs de interacción entre features: hay fallas en cómo interactúa el constrained decoding con otras funciones del motor. Un ejemplo puntual: el choque entre constrained decoding y speculative decoding puede hacer que tokens especulativos sean rechazados por la grammar de forma incorrecta, tirando abajo requests que debieron funcionar.
Por estas tres categorías de problemas, los mantenedores de vLLM optaron por dejar la feature apagada por default para un motor pensado para ser agnóstico de modelo. Más adelante agregaron la flag --tool-strict-level para que cada quien decida activarla donde le convenga.
¿Cómo se activa el constrained decoding en vLLM 0.31 y qué resultados da?
El constrained decoding se activa en vLLM 0.31 mediante la flag --tool-strict-level, que le permite a cada despliegue habilitar la validación estricta de esquema sin depender del comportamiento default del motor. Ubicloud la activó específicamente para los modelos Kimi y DeepSeek que sirve en producción. Más contexto en cómo 13 CMS diseñaron sus herramientas MCP.
El enfoque de Ubicloud es distinto al de vLLM como proyecto. Mientras vLLM necesita ser seguro para cualquier modelo, Ubicloud se enfoca en servir Kimi y DeepSeek con la calidad que esperás de un proveedor de primera mano. Por eso, después de activar la flag, volvieron a correr el benchmark K2VV ToolCall y confirmaron 100% de tool-call schema accuracy en todas las versiones de modelo que sirven, antes de mandar el cambio a producción.
Esto no significa que subir a vLLM 0.31 te garantice 100% de accuracy sin hacer nada. Según un caso reportado por un equipo que self-hosteó Qwen2.5-7B-Instruct, la progresión de mejoras fue gradual: con parser equivocado, accuracy alrededor de 70%; corrigiendo el parser con tool_choice="auto", subió a 86%; pasando a tool_choice="required" con validación Pydantic, llegó a 93%; y agregando un retry con feedback específico del error, terminó arriba de 97.5%. La configuración del servidor importa tanto como la flag.
Comparativa: accuracy según configuración de vLLM
| Escenario | Configuración de constrained decoding | Schema accuracy reportada |
|---|---|---|
| Kimi K2.6 en vLLM 0.28 | Desactivado (default) | 92% |
| Kimi K2.6 tras cambio de default en vLLM post v0.25 | No activado por default | 91% |
| Kimi K2.6 y DeepSeek en vLLM 0.31 (Ubicloud) | Activado vía --tool-strict-level | 100% |
| Qwen2.5-7B-Instruct self-hosted, parser incorrecto | Guided decoding sin usar / parser mal configurado | ~70% |
| Qwen2.5-7B-Instruct, parser corregido + required + Pydantic + retry | tool_choice="required", validación semántica, retry con feedback | ~97.5% |
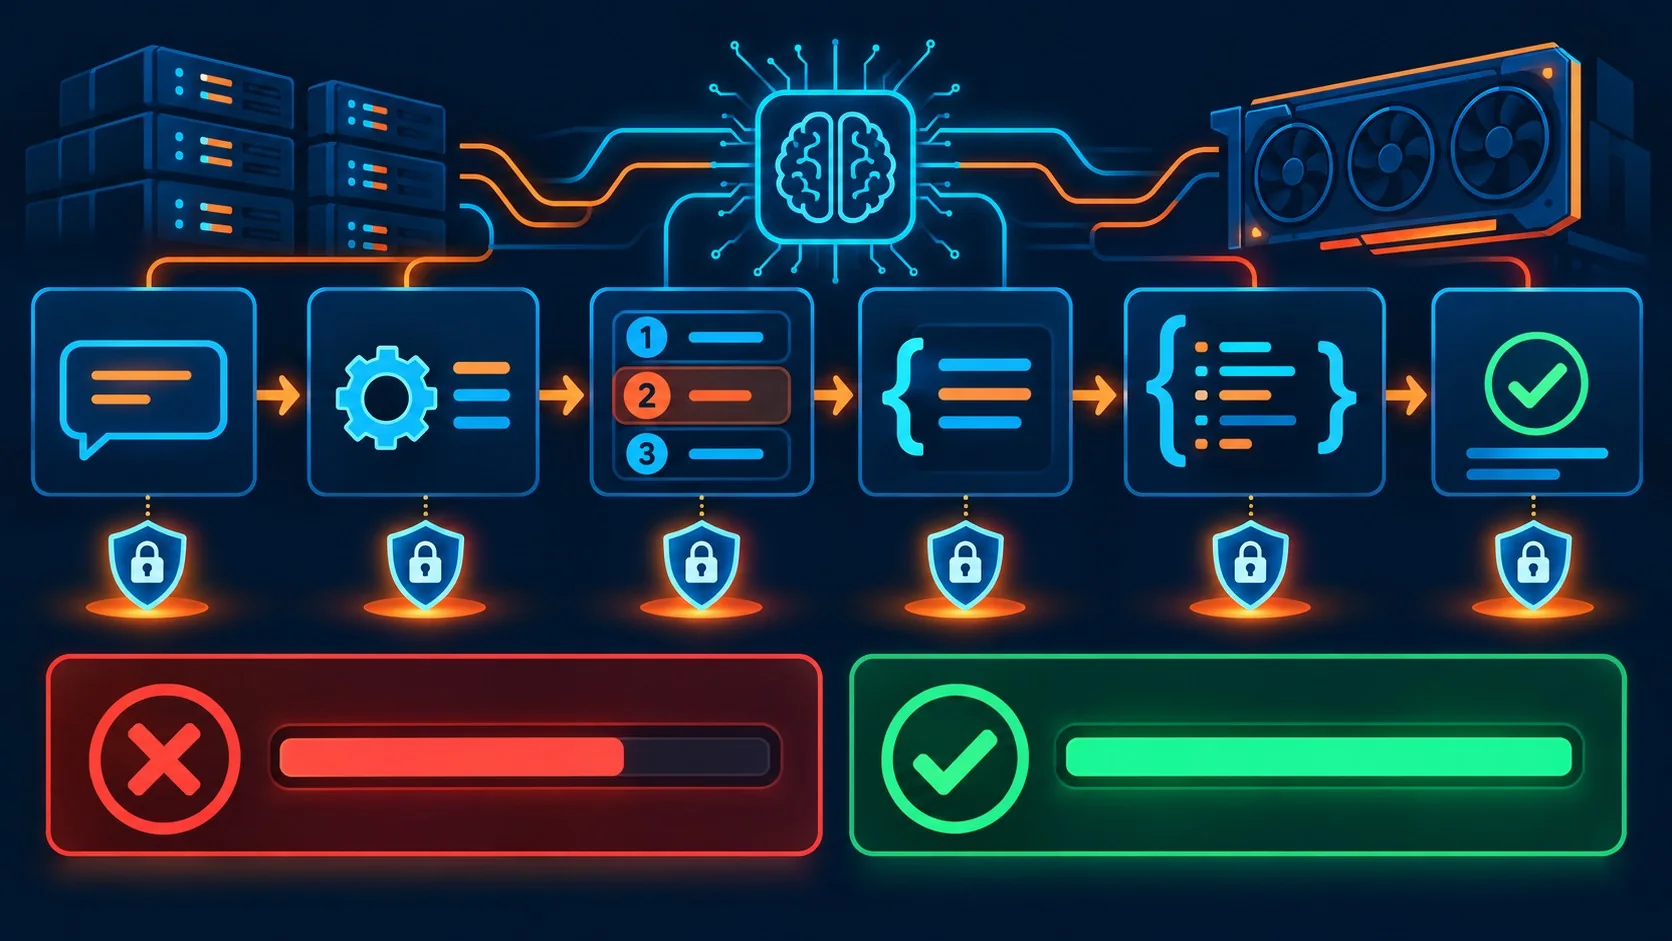
La tabla deja algo claro: la flag sola no alcanza si el modelo es chico o la configuración del parser está mal. Para Kimi y DeepSeek, servidos con el parser correcto desde el vamos, activar --tool-strict-level alcanza para llegar a 100%. Para un modelo más chico con configuración rota, hay que corregir varias capas antes de ver resultados comparables.
Errores comunes al configurar tool calling en vLLM
- Asumir que la calidad depende solo del modelo: el motor de inferencia también define el comportamiento default. Cambiar de un fork propio a vLLM upstream, sin revisar qué flags cambiaron, puede bajarte la accuracy aunque el modelo sea el mismo.
- Usar el parser equivocado para la familia del modelo: Qwen y Hermes necesitan
--tool-call-parser hermes, Llama 3.x necesitallama3_json, Mistral necesitamistral. Si lo configurás mal, el parser nunca matchea y todo tool call termina como texto plano. - Activar constrained decoding sin probar el modelo puntual: gpt-oss-20b, Qwen 3.6 y GLM 5.1 tuvieron problemas cuando esta feature se activó por default. Antes de forzarla en producción, corré el benchmark propio con ese modelo específico.
- Confundir validez sintáctica con validez semántica: constrained decoding garantiza que el JSON cumple el schema, no que los valores tengan sentido de negocio. Una fecha como
2026-02-30pasa la validación sintáctica aunque no exista en el calendario; ahí hace falta una capa de validación adicional, por ejemplo con Pydantic. - Medir con “probé unos prompts y anduvo bien”: eso es lo que deja pasar bugs a producción. Armar un set de casos reales (schema accuracy medida, no sensación) y correrlo cada vez que cambiás modelo, template o prompt es la única forma de detectar regresiones a tiempo.
Preguntas Frecuentes
¿Qué es la precisión de esquema (schema accuracy) en tool calling?
La schema accuracy es el porcentaje de tool calls generadas por un modelo que cumplen el JSON schema de la herramienta invocada y pueden ejecutarse sin error. Si la accuracy es 92%, como midió Ubicloud en Kimi K2.6 con vLLM 0.28, significa que 8 de cada 100 llamadas fallan por campos incorrectos, nombres inválidos o tipos mal formados.
¿Cómo funciona el constrained decoding en vLLM?
El constrained decoding restringe, en cada paso de generación de tokens, el conjunto de opciones válidas según el schema de la herramienta, usando structural tags de la librería XGrammar. En vez de validar el JSON después de generarlo, el motor enmascara los tokens inválidos antes de que el modelo pueda elegirlos, garantizando una llamada sintácticamente correcta en cada fase del proceso.
¿Por qué vLLM desactiva el constrained decoding por defecto?
vLLM lo desactiva por defecto porque activarlo para todos los modelos generó fallas en varios de ellos, entre ellos gpt-oss-20b, Qwen 3.6 y GLM 5.1. Al ser un motor agnóstico de modelo, los mantenedores priorizaron la estabilidad general sobre forzar una feature que no funciona igual de bien en todas las arquitecturas.
¿Cómo se activa el constrained decoding en vLLM 0.31?
Se activa con la flag --tool-strict-level, agregada en la versión 0.31 de vLLM, que le permite a cada despliegue habilitar la validación estricta de esquema por modelo. Ubicloud la activó para Kimi y DeepSeek y confirmó 100% de schema accuracy en el benchmark K2VV ToolCall tras el cambio.
¿Qué mide el benchmark K2VV ToolCall de Moonshot AI?
El benchmark K2VV ToolCall mide dos métricas sobre 2000 requests: trigger similarity, que compara cuándo el servicio evaluado decide disparar una herramienta respecto al servicio propio de Moonshot AI, y schema accuracy, que mide qué fracción de las llamadas generadas respeta el schema de la herramienta invocada.
Conclusión
El caso de Ubicloud deja un dato concreto para cualquiera que sirva modelos open-weight con vLLM: la versión y la configuración del motor de inferencia pesan tanto como el modelo elegido. Pasar de 92% a 100% de precisión tool calling vLLM no implicó cambiar de modelo, implicó activar una flag que ya existía en el motor pero venía apagada por decisión de diseño.
Si estás sirviendo Kimi, DeepSeek o cualquier otro modelo con soporte confirmado de constrained decoding en vLLM, lo primero es chequear la versión que tenés corriendo y si --tool-strict-level está disponible. Después, antes de activarla en producción, correla contra un benchmark propio con casos reales, no contra “unos prompts que probé a mano”. Y si tu modelo es más chico o menos estándar, revisá si entra en alguna de las tres categorías de problemas que documentó Ubicloud antes de asumir que la flag te va a resolver todo sola.
Lo que no está confirmado todavía, al menos en las fuentes disponibles, es si vLLM va a extender el soporte de constrained decoding sin fricción a modelos como gpt-oss-20b o GLM 5.1 en próximas versiones. Hasta que eso pase, la recomendación práctica es activar la flag donde ya funciona bien documentado, y medir antes de mandar a producción.