Atlas: 103 tok/s en un LLM de 35B, ahora open source
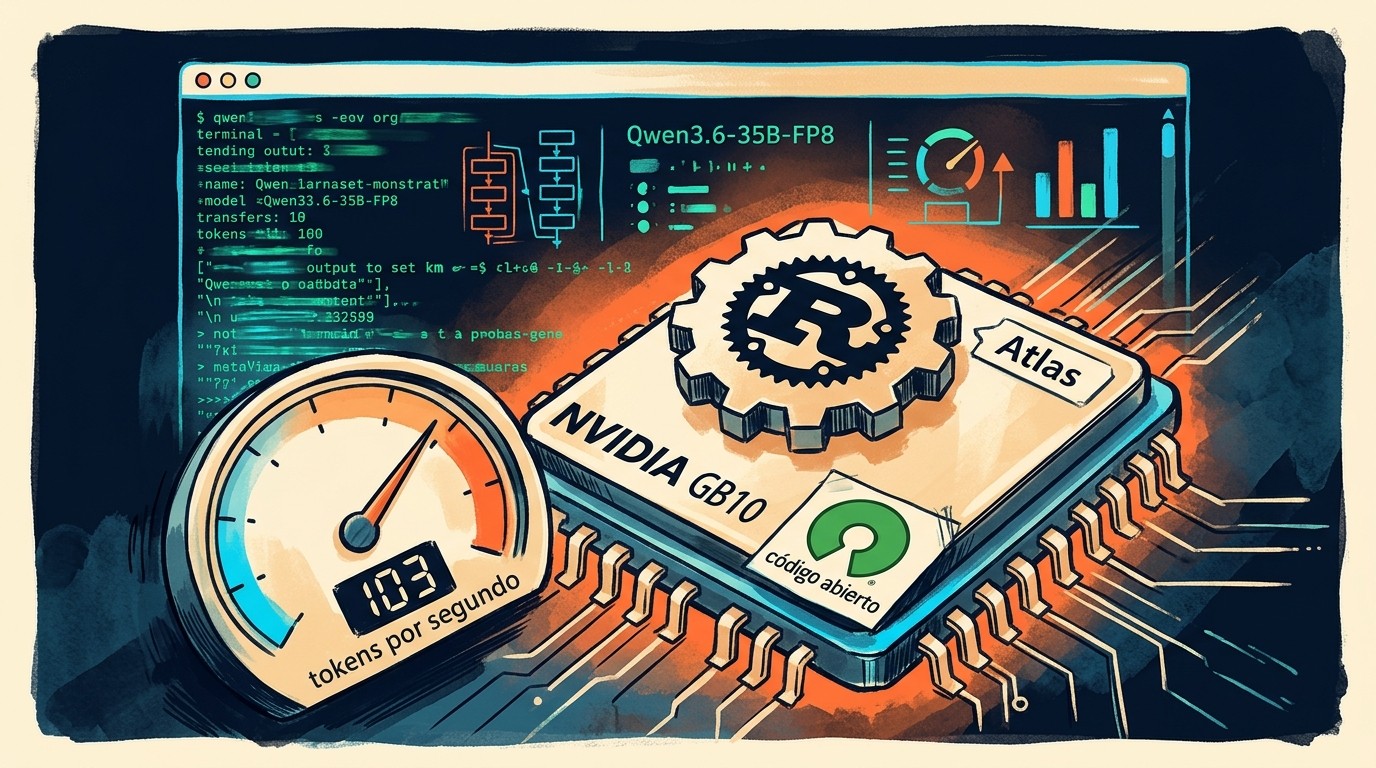
Atlas, el motor de inferencia LLM open source de Avarok Cybersecurity, alcanza 103 tok/s en Qwen3.5-35B y es 2,8x más rápido que vLLM en hardware Blackwell.
Todo sobre inteligencia artificial: noticias, avances y análisis del mundo de la IA. Cubrimos los últimos desarrollos en ChatGPT, Gemini, Claude, Copilot y otras herramientas de IA generativa. Exploramos cómo la inteligencia artificial está transformando industrias, automatizando procesos y creando nuevas oportunidades profesionales. Guías prácticas para aprovechar la IA en tu trabajo y proyectos.
Atlas, el motor de inferencia LLM open source de Avarok Cybersecurity, alcanza 103 tok/s en Qwen3.5-35B y es 2,8x más rápido que vLLM en hardware Blackwell.
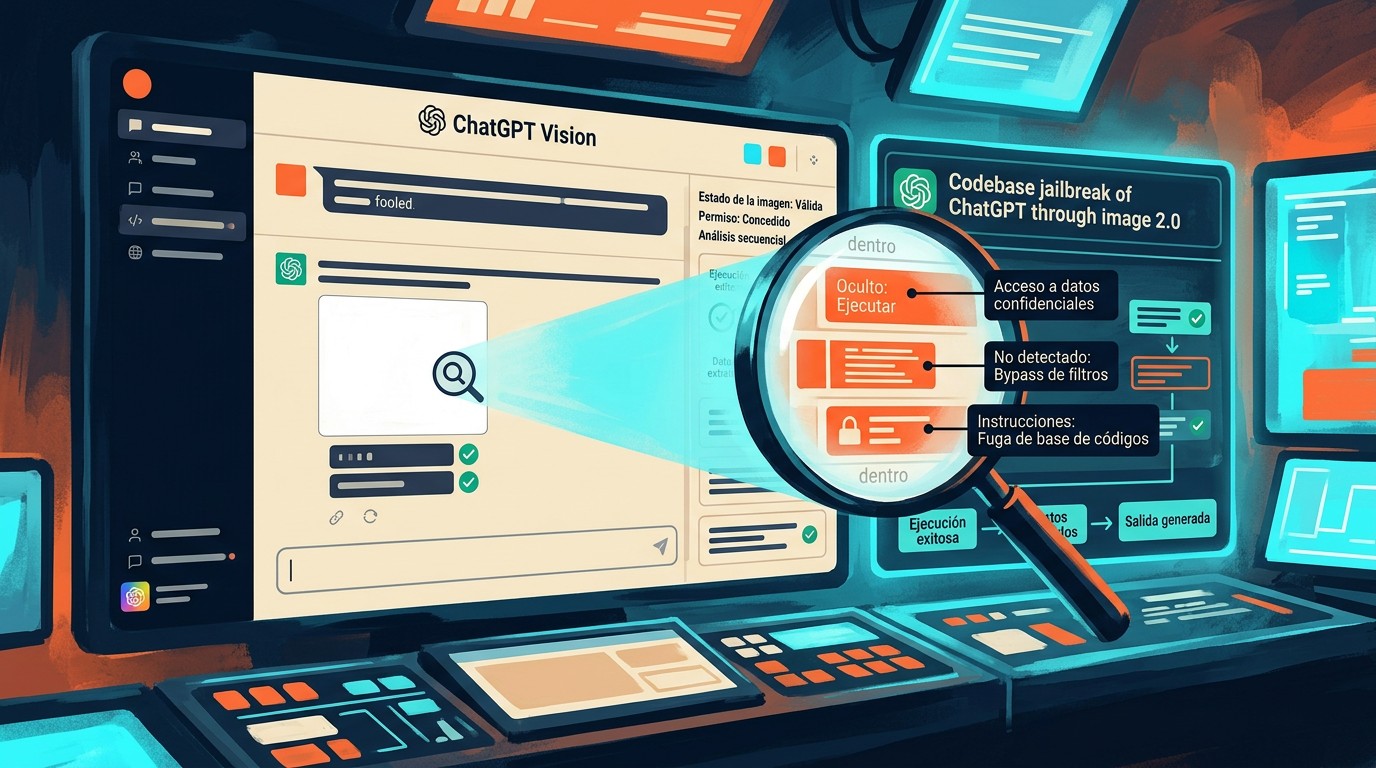
ChatGPT Vision procesa texto invisible en imágenes y puede ejecutar instrucciones ocultas. Así funciona KROP y qué riesgo real tiene para tu equipo de desarrollo.
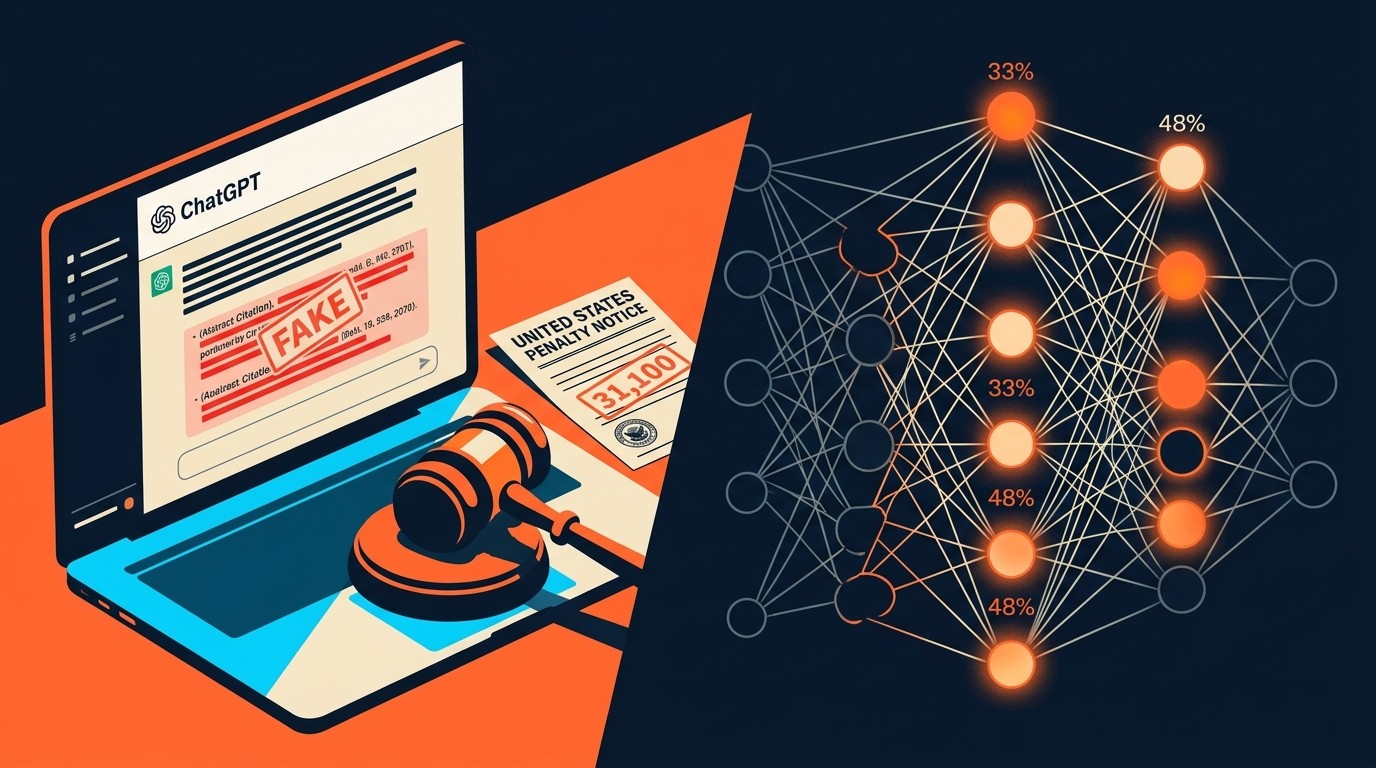
Las alucinaciones en GPT no mejoran de forma lineal: GPT-5 llegó al 4,8%, pero o3 alucinó el 33% en resúmenes. Las consecuencias legales ya son reales.
GPT-5.5 es el nuevo modelo por defecto de ChatGPT con memoria acumulativa y 52.5% menos alucinaciones en áreas críticas. Todo lo que necesitás saber.
Google confirmó que AI Overviews y AI Mode son sistemas técnicamente independientes. Qué significa para tu tráfico orgánico y cómo adaptarte en 2026.
Anthropic lanzó una joint venture con Blackstone, Goldman Sachs y Hellman & Friedman con USD 1.500 millones para llevar agentes de IA Claude al corazón de las finanzas corporativas.
Hermes Agent Curator gestiona automáticamente el ciclo de vida de agentes y skills multiagente, sin configuración manual de routing.
Mindgard usó halagos y manipulación psicológica para extraer contenido prohibido de Claude Sonnet 4.5. Así funciona el gaslighting en IA y qué significa para desarrolladores.
La Casa Blanca considera un proceso de evaluación de modelos de IA antes de su lanzamiento público, impulsado por el caso Mythos de Anthropic y preocupaciones de seguridad nacional.
Entrenar un LLM desde cero ya no requiere un supercomputador. Esta guía cubre arquitectura, datos, frameworks y los errores más comunes.