9 bugs que parecian un sistema funcionando (y no)
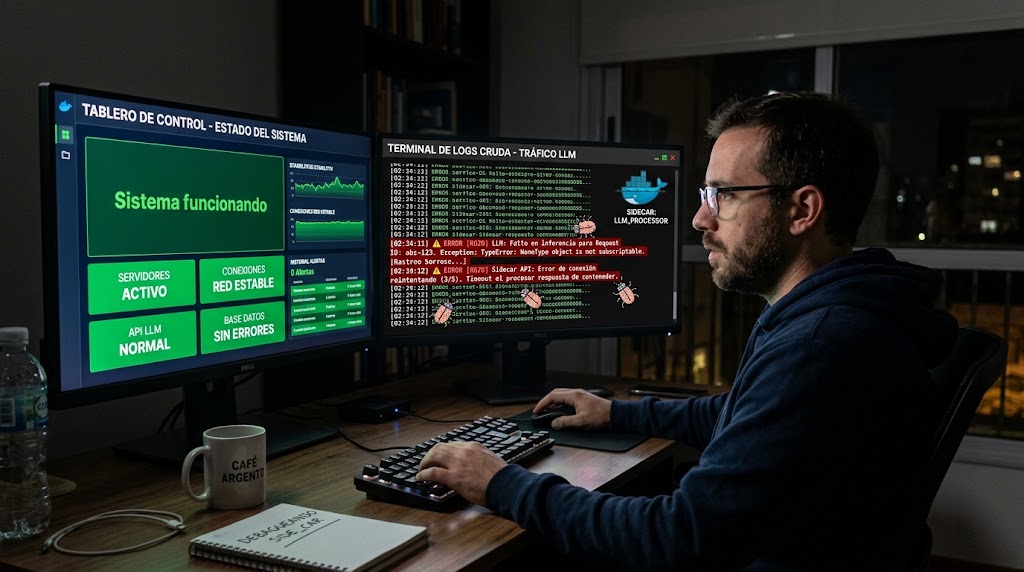
El caso real de un sidecar de IA con 9 bugs fundamentales que hacian parecer que todo andaba. Como cazarlos leyendo el trafico crudo del LLM.
El caso real de un sidecar de IA con 9 bugs fundamentales que hacian parecer que todo andaba. Como cazarlos leyendo el trafico crudo del LLM.
Comparativa directa de Groq y TokenPAPA: cuándo pagar por velocidad LPU y cuándo elegir precio bajo con 30+ modelos y caching automático.
El multiplicador 20x de Claude Max aplica solo a la ventana de 5 horas, no al límite semanal. Qué pagás realmente por USD 200/mes.
Cómo ordenar la optimización inferencia LLM en dos familias de técnicas: las que negocian latencia y throughput y las que expanden toda la frontera.
Un transformer de 8 capas entrenado en 1,5 horas por 67 centavos sacó 44% en ARC-AGI-1 y empató a TRM y HRM. Qué hay detrás del resultado.
La pérdida de savviness con LLMs es la erosión de la astucia práctica que sufre un desarrollador al delegar su razonamiento en modelos de IA. Paolo Galeone, un ingeniero de software con 15 años de carrera, relata cómo pasó de ser un creador apasionado a un aburrido evaluador de prompts.
OpenAI está probando un modo persistente para Codex que permite a los agentes funcionar sin parar en segundo plano, generar sus propias tareas y contactar al usuario proactivamente. Sin fecha de lanzamiento pero con implicancias de seguridad documentadas por la propia empresa.
Anthropic anunció el Model Hardware Standard (MHS), un estándar abierto que permite a agentes de IA controlar dispositivos físicos con lenguaje natural. Resultados de pruebas con Genentech, Carnegie Mellon y QuEra muestran automatización 3× más rápida y 99.3% de recuperación de fallos.
Google Cloud presentó OpEmbed en ISSRE 2026, un framework que genera huellas operacionales de LLMs usando metadatos de soporte. Probado con más de 33.000 casos reales durante 26 meses, predice tasas de bugs con R² de 0.807 sin tocar texto de clientes.
DeepSeek V4 Flash lidera la relación precio-rendimiento en APIs de asistente de codificación IA en 2026, con 82.7 en Terminal Bench 2.1 y USD 0.14 por millón de tokens de entrada.